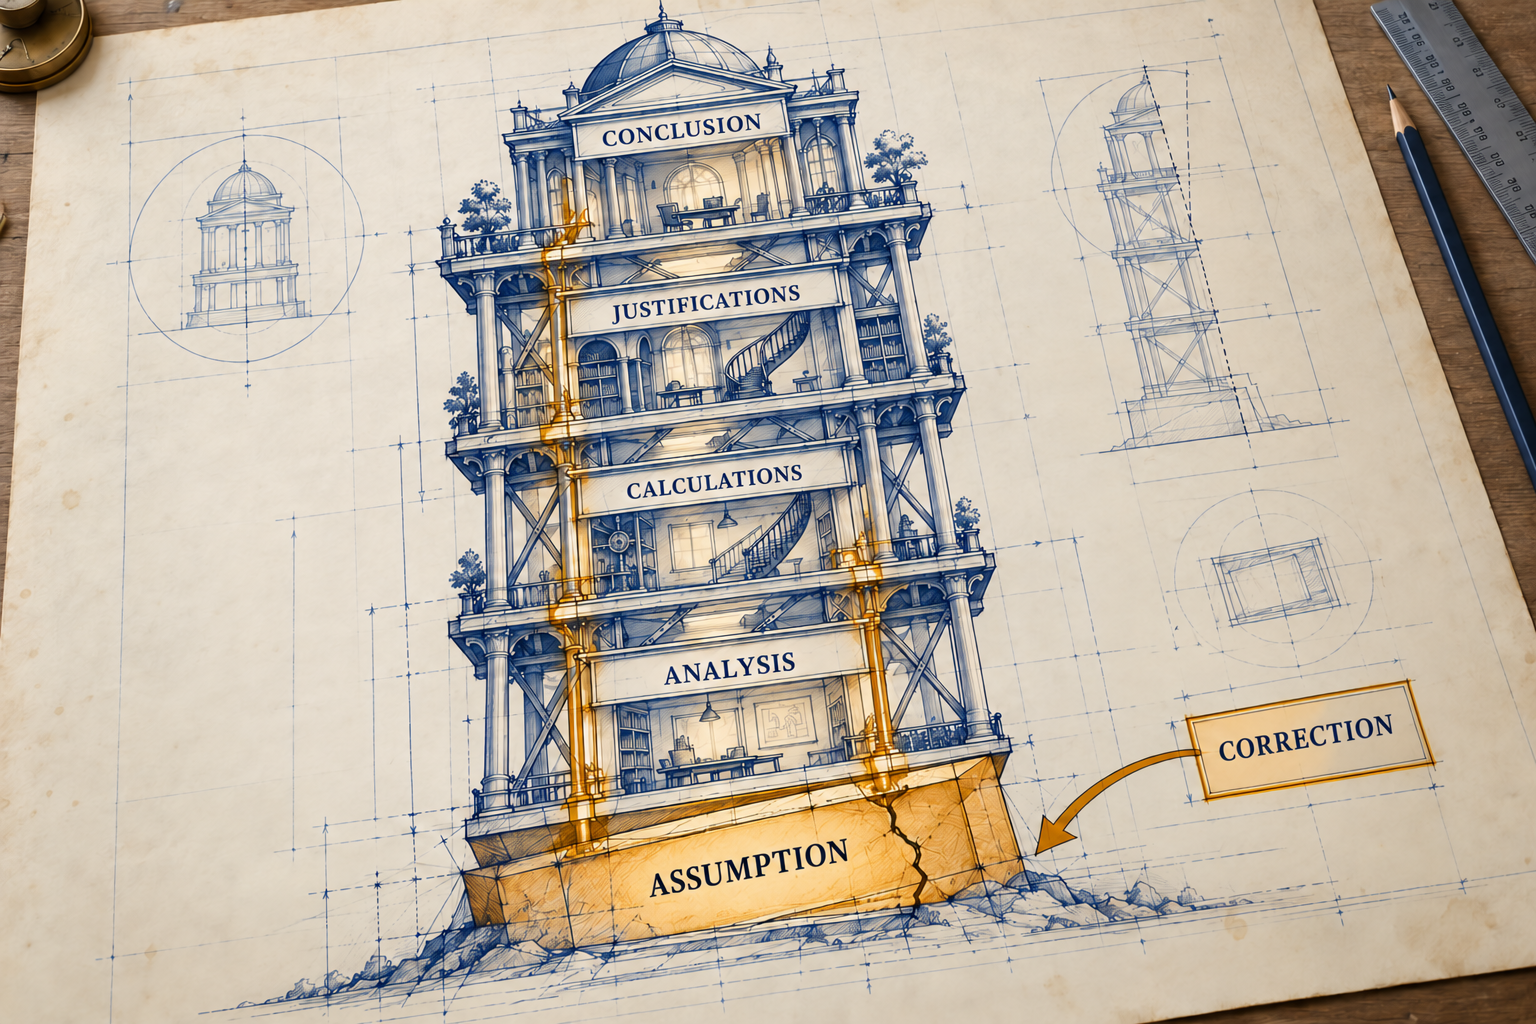
Una premisa equivocada puede atravesar una respuesta entera. Dar más espacio al razonamiento también debe dejar espacio para revisar el punto de partida.
Escena hipotética.
La investigadora tiene baja visión y trabaja por voz, con lector de pantalla. Entrega a una IA una tabla de un estudio pequeño. Los mismos participantes realizaron una tarea antes y después de un cambio de interfaz.
Pregunta: «¿Esta diferencia es significativa?».
En la explicación presentada por el modelo aparece una decisión: «Trataré los dos grupos como muestras independientes».
Pero no son dos grupos independientes. Son las mismas personas medidas dos veces.
El modelo sigue. Elige un análisis basado en esa suposición, presenta cálculos y concluye que la diferencia no es significativa. Incluso sugiere reescribir la discusión del artículo para «no exagerar el efecto».
La respuesta llega organizada. La premisa que sostiene esa organización es incorrecta.
No tenemos datos reales en esta escena para calcular la significación ni elegir por completo una prueba. El error ilustrado es anterior: el sistema ignoró la relación entre las medidas. Elegir el análisis también exigiría examinar el diseño, la variable y sus condiciones.
La investigadora corrige: «Son medidas repetidas, con los mismos participantes».
Ahora debe comprobar otra cosa: ¿la corrección cambió el análisis o solo añadió una disculpa antes de la misma conclusión?
Qué estoy llamando autoenvenenamiento
Uso autoenvenenamiento como una metáfora de la propagación de una suposición producida por el propio modelo. Introduce una premisa inadecuada y construye respuestas que siguen apoyándose en ella.
El término acerca fenómenos estudiados como acumulación de errores y hallucination snowballing. No propongo que todos sean el mismo mecanismo, ni describo una intención del modelo de engañar o una experiencia humana de convicción.
En esta escena, el problema aparece durante una respuesta. En la crónica «Corregí la conversación. La conversación me corrigió a mí.» [1], aparece en la continuidad de la colaboración. Son escalas diferentes de una pregunta común: ¿cómo una suposición de la herramienta pasa a orientar el trabajo después de haber sido corregida?
Pensar más puede ayudar. La premisa todavía debe ser correcta.
El trabajo de Wei y colegas, presentado en 2022, mostró mejoras al ofrecer ejemplos de resolución paso a paso en tareas aritméticas, de sentido común y simbólicas. Contribuyó a establecer la cadena de pensamiento, o chain-of-thought, como una forma útil de generar pasos intermedios. Estudio original [2].
Los modelos actuales han ido más allá de ese procedimiento de prompting. GPT-6.1 Sol, por ejemplo, está documentado como modelo de razonamiento con distintos niveles de esfuerzo. Estos controles permiten ajustar el procesamiento; el nivel elegido, por sí solo, no mide la corrección de la respuesta. Documentación oficial, consultada el 24/10/2026 [3].
También debemos separar tres cosas: procesamiento interno, pasos intermedios generados en tokens y explicación entregada a la persona.
En la API de OpenAI no se exponen los tokens brutos de razonamiento; cuando está disponible y se solicita, el sistema ofrece un resumen. Por tanto, no debe suponerse que un panel llamado «pensamiento» es una transcripción completa del cálculo. La política de presentación depende del producto y del modelo. OpenAI Docs — resúmenes de razonamiento [4].
En la escena de la investigadora, la premisa equivocada está en la explicación observable. Permite comprobar el análisis propuesto. Por sí sola, no permite reconstruir cada operación interna que llevó a la conclusión.
Cómo un error puede convertirse en material para el siguiente paso
En la generación autorregresiva de texto, la distribución del siguiente token depende de la entrada y del prefijo ya generado. Una representación simplificada es:
P_\theta(y_t \mid x, y_{<t}).Aquí, x representa la entrada, y_t el siguiente token e y_<t los tokens anteriores de la generación. Es una descripción del condicionamiento secuencial, no un diagrama completo de toda arquitectura actual.
Si un paso intermedio incorrecto permanece en el material utilizado para continuar la generación, puede influir en los pasos siguientes. Una factorización inventada puede sostener una cuenta; una relación inexistente puede sostener una conclusión. Ese encadenamiento es lo que interesa investigar.
En los Transformers con atención causal, la atención ayuda a combinar representaciones de las posiciones permitidas por la máscara. Esta operación, por sí sola, no certifica que una premisa sea verdadera. Hay otras transformaciones en la red, y los modelos pueden aprender a revisar lo que producen. Arquitectura del Transformer [5].
Por eso sería demasiado grande el salto de «el texto anterior puede influir en la continuación» a «el modelo siempre refuerza el primer error». El mecanismo ofrece una posibilidad de propagación; la aparición y la intensidad deben medirse.
Los sistemas también pueden registrar el origen de cada afirmación y distinguir hipótesis, dato y corrección. Esa distinción debe tener consecuencias en la ejecución. Escribir «hipótesis» junto a una frase no garantiza que el resto del análisis deje de tratarla como un hecho.
Lo que observó la investigación
Errores que producen otros errores. En How Language Model Hallucinations Can Snowball, Zhang y colegas estudiaron en 2023 modelos que justificaban una respuesta inicial incorrecta con afirmaciones falsas que podían reconocer como erróneas al examinarlas por separado. Es evidencia de compromiso con el error en las configuraciones evaluadas. No establece una tasa para los modelos de 2026. Artículo [6].
Explicaciones que omiten influencias. Turpin y colegas mostraron que pistas sesgadas podían cambiar respuestas sin mencionarse en las justificaciones. Eso hace arriesgado tratar una cadena convincente como prueba completa de la causa de la respuesta. El estudio es de 2023 y evalúa ese protocolo específico. Artículo [7].
Orden de las premisas. Chen y colegas observaron en 2024 variaciones de rendimiento al reorganizar premisas sin cambiar el problema lógico. En las evaluaciones, el orden alineado con la resolución favorecía a los modelos. Indica sensibilidad a la presentación; no prueba que la primera frase determine cualquier respuesta. Artículo [8].
Más procesamiento con peores resultados en ciertas tareas. Gema y colegas construyeron tareas en las que ampliar el razonamiento reducía el rendimiento, entre ellas recuentos con distractores y deducciones con restricciones. La versión publicada en TMLR en diciembre de 2025 registra diferencias entre modelos y configuraciones. Es un contraejemplo a la garantía de mejora, sin convertir «pensar menos» en regla general. Estudio y versión publicada [9].
Estas investigaciones observan aspectos relacionados. Reunirlas no demuestra una única explicación causal para toda respuesta segura y equivocada.
La investigación también avanzó sobre cómo interpretar el razonamiento
Un trabajo de Zaman y Srivastava, publicado en ACL de 2026, cuestiona una interpretación fuerte de ciertas pruebas de fidelidad: que una explicación omita una pista que influyó en la respuesta no basta, de forma aislada, para concluir que toda la cadena es una racionalización posterior.
Los autores comparan medidas e intervenciones causales; muestran que la evaluación depende de cómo se haya definido la «fidelidad». Eso no declara fiables todas las cadenas. Pide más cuidado al utilizar una explicación incompleta como evidencia de un mecanismo interno específico. Artículo de 2026 [10].
Este avance importa para el argumento del post. Podemos señalar una premisa falsa, comprobar su efecto en el análisis y exigir una revisión. No necesitamos afirmar que vemos todo el proceso interno para hacerlo.
La autocorrección puede aprenderse
El estudio de Huang y colegas, publicado en ICLR de 2024, encontró dificultades en la autocorrección intrínseca: pedir al modelo que revisara su propia respuesta sin información externa podía mantener o agravar errores. Son resultados de los modelos y las tareas de ese estudio. Artículo [11].
Después, SCoRe mostró que el aprendizaje por refuerzo en interacciones de varios turnos podía mejorar la autocorrección en matemáticas y código. El método se presentó en 2024 y se publicó en ICLR de 2025. SCoRe [12].
Hay una diferencia entre pedir «revisa» a un modelo y entrenarlo para reconocer y reparar sus propios errores. Estos trabajos ayudan a estudiar esa diferencia. No permiten concluir que todo modelo actual sea incapaz de corregirse, ni que un entrenamiento elimine cualquier fallo.
Lo mismo se aplica a las correcciones externas. Una herramienta, una persona o una prueba pueden aportar evidencia útil. Su calidad y la forma en que el sistema la incorpora siguen necesitando comprobación.
Comprobar el camino exige más de una estrategia
La autoconsistencia, propuesta por Wang y colegas, genera distintas vías de resolución y combina sus respuestas. La diversidad puede ayudar a evitar depender de una sola secuencia. Sin embargo, varias muestras del mismo modelo pueden compartir la misma suposición equivocada; la coincidencia no certifica la verdad. Self-consistency [13].
La supervisión por proceso, estudiada por Lightman y colegas, evalúa pasos intermedios durante el entrenamiento de verificadores. En el conjunto MATH evaluado superó a la supervisión únicamente del resultado final. Eso respalda la importancia de comprobar los pasos; no equivale a pedir una justificación más larga al mismo modelo y considerarla validada. Let's Verify Step by Step [14].
Para la investigadora, una comprobación externa puede empezar por el diseño del estudio: cada medida anterior debe corresponder a la misma persona en la medida posterior. Un programa puede comprobar ese emparejamiento, recalcular el análisis especificado y mostrar los datos utilizados. El programa también exige revisión: ejecutar código no garantiza haber elegido el modelo estadístico adecuado.
Una corrección debe alcanzar sus consecuencias
En la escena me gustaría ver una revisión así:
Parte del trabajo: Hipótesis de trabajo; Qué debe cambiar después de la corrección: Retirar «muestras independientes» y registrar el emparejamiento indicado
Parte del trabajo: Procedimiento; Qué debe cambiar después de la corrección: Revisar el análisis según el diseño y las condiciones de los datos
Parte del trabajo: Cálculo y conclusión; Qué debe cambiar después de la corrección: Recalcular lo necesario y mostrar qué resultados cambiaron
Este es un contrato de colaboración propuesto, no la descripción de una función ya disponible en Kuaapy.
Una disculpa no demuestra que la corrección haya recorrido esas dependencias. La persona debe poder comprobar qué se retiró, qué se rehízo y de dónde salió la nueva conclusión.
Eso también permite evaluar el sistema sin exigir acceso a todo el razonamiento privado: registrar la suposición presentada, aportar la corrección y comprobar las consecuencias observables.
En un experimento compararía distintos casos y modos de revisión: una petición genérica de comprobación, una corrección explícita de la premisa y una corrección acompañada de evidencia externa. Mediría aciertos recuperados, respuestas correctas que se volvieron incorrectas, fidelidad a los datos y coste de revisión. Importan las repeticiones y la variación entre casos. Aquí presento el diseño, no resultados de una prueba ya realizada.
El coste de encontrar la premisa equivocada
Aquí entra mi argumento de accesibilidad, todavía sin una medida comparativa propia.
Una persona que revisa con lector de pantalla puede necesitar recorrer bastante contenido para localizar una suposición en medio de la explicación. Navegar por títulos, disponer de una lista breve de hipótesis y poder volver directamente al paso corregido pueden reducir ese esfuerzo.
Las experiencias varían. La baja visión, el uso de voz y la neurodivergencia no determinan una sola forma de leer o de utilizar la memoria de trabajo. El problema de diseño aparece cuando la herramienta exige reconstruir todo el análisis para descubrir si escuchó una corrección.
En vez de suponer que transparencia significa mostrar mil líneas, pediría premisas de trabajo breves, navegables y vinculadas a las evidencias. Ese registro ayudaría a comprobar la tarea; no tendría que fingir una reproducción íntegra del procesamiento interno.
La investigadora indicó que eran las mismas personas. La siguiente respuesta debe trabajar con esa información y hacer verificable el cambio.
Habla con nosotros
¿Has corregido una suposición y recibido la misma conclusión con una explicación nueva? Cuéntanos en privado qué premisa debía cambiar y qué hizo después la herramienta. Evita nombres, documentos privados y datos sensibles. Publicar un relato exige una autorización propia.
Dudas, correcciones y sugerencias: [email protected].
Para seguir leyendo
• Wei y colegas — Chain-of-Thought Prompting [2].
• OpenAI Docs — GPT-6.1 Sol [3] y resúmenes de razonamiento [4].
• Zhang y colegas — Hallucination Snowballing [6].
• Turpin y colegas — Unfaithful Explanations [7].
• Chen y colegas — Premise Order Matters [8].
• Gema y colegas — Inverse Scaling in Test-Time Compute [9].
• Zaman y Srivastava — fidelidad y omisión de pistas, ACL2026 [10].
• Huang y colegas — autocorrección intrínseca [11] y Kumar y colegas — SCoRe [12].
• Wang y colegas — Self-Consistency [13].
• Lightman y colegas — Let's Verify Step by Step [14].
Fuentes y lecturas
- [1] «Corregí la conversación. La conversación me corrigió a mí.»
- [2] Estudio original
- [3] Documentación oficial, consultada el 24/10/2026
- [4] OpenAI Docs — resúmenes de razonamiento
- [5] Arquitectura del Transformer
- [6] Artículo
- [7] Artículo
- [8] Artículo
- [9] Estudio y versión publicada
- [10] Artículo de 2026
- [11] Artículo
- [12] SCoRe
- [13] Self-consistency
- [14] Let's Verify Step by Step