Você pede ajuda para explorar uma ideia.
A ferramenta supõe que você quer implementá-la imediatamente. Pergunta pela arquitetura. Você explica que ainda está pesquisando. Ela pede critérios de implementação. Você corrige outra vez.
A ideia continua esperando. A conversa já tem um projeto inteiro que você nunca pediu.
Cena hipotética. Talvez o seu assunto fosse outro. O caminho pode ser familiar.
Quando a suposição vira o assunto
Uma pergunta pode ajudar muito. O problema começa quando ela carrega uma conclusão que ainda não foi combinada.
Você responde para desfazer a conclusão. A ferramenta interpreta a resposta dentro daquela mesma conclusão. Agora precisa de outra pergunta. Depois, de outra.
A cada rodada, o histórico ganha material sobre o caminho errado. A tarefa original ocupa poucas linhas; a discussão para recuperar a tarefa ocupa páginas.
Neste post, chamamos isso de envenenamento do contexto: um ciclo em que interpretações introduzidas pelo modelo passam a orientar a conversa, dificultando a revisão dessas próprias interpretações.
Não estamos falando aqui de um ataque externo. Estamos falando de uma colaboração que vai ficando presa no que a ferramenta acrescentou.
Mais conversa, menos avanço
Iterar é poder tentar, receber uma resposta e ajustar o caminho. A pessoa pode descobrir o que quer enquanto conversa.
Quando cada ajuste vira uma nova cobrança para justificar o pedido, essa possibilidade se perde. Você precisa convencer a ferramenta a voltar ao ponto de partida.
“Não foi isso que eu pedi” deveria permitir uma mudança de rumo. Se vira apenas mais uma frase anexada ao histórico, o erro ganha companhia em vez de ser corrigido.
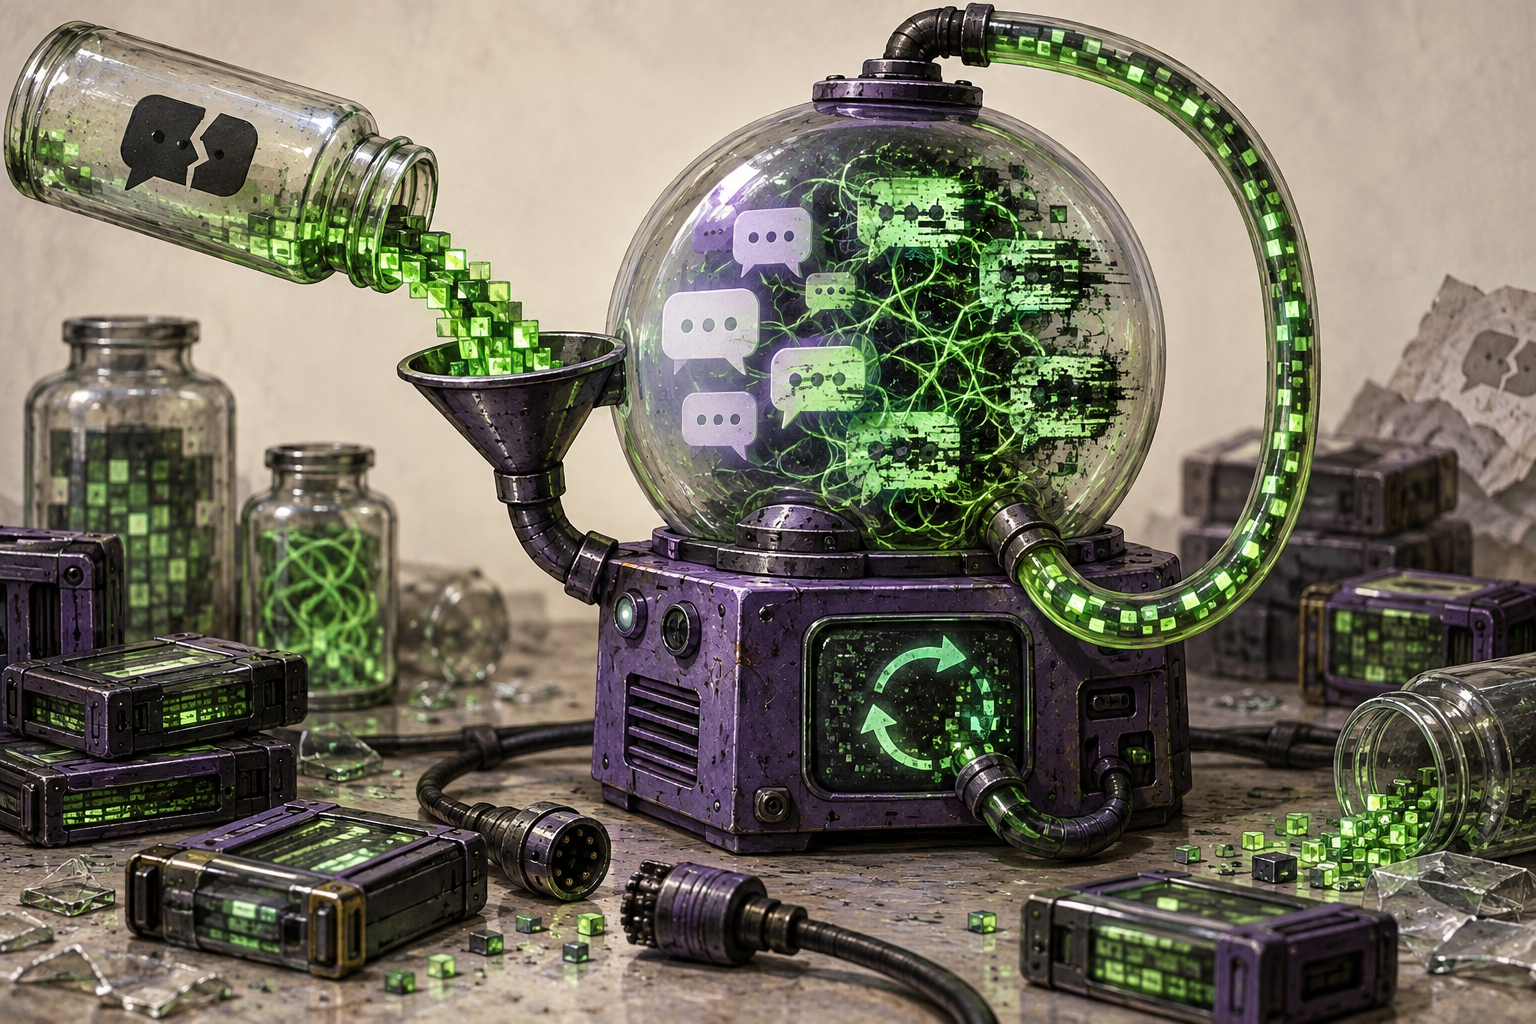
A máquina da imagem recebe dados contaminados e os faz circular novamente. Essa é a metáfora: o contexto produzido pela própria ferramenta volta a alimentar suas próximas respostas.
A pesquisa encontrou um problema próximo
Laban e colegas estudaram tarefas distribuídas em várias rodadas de conversa. Nos experimentos, os modelos testados frequentemente fizeram suposições precoces e se apoiaram demais nas soluções inicialmente geradas, com dificuldade para recuperar o rumo. É evidência de um problema de confiabilidade conversacional; não demonstra que toda pergunta é prejudicial nem reproduz exatamente a cena deste post. Leia LLMs Get Lost In Multi-Turn Conversation.
O resultado ajuda a formular uma exigência simples: uma ferramenta conversacional precisa conseguir revisar o que ela mesma presumiu.
O que acontece tecnicamente, em linguagem simples
O modelo não responde apenas à sua última frase. Em um chat, ele recebe um contexto: instruções, mensagens anteriores e outros materiais que o aplicativo incluir. Pense nisso como a mesa de trabalho disponível para elaborar a próxima resposta.
Esse texto é dividido em pequenos pedaços chamados tokens. Nos modelos baseados em Transformer, a self-attention relaciona esses pedaços e combina informações entre eles. Assim, trechos anteriores podem influenciar o que será gerado. Atenção é um cálculo; não é uma avaliação automática da verdade. O mecanismo foi apresentado em Attention Is All You Need.
Aqui está o ponto: uma resposta errada do próprio modelo pode voltar como parte do contexto da rodada seguinte. Ela passa a estar na mesa junto com o pedido e com a sua correção.
Imagine que você diga “quero explorar possibilidades” e o modelo responda “vamos preparar o lançamento”. Se essa interpretação continuar orientando as próximas respostas, a conversa passa a girar em torno de um lançamento que você não solicitou.
O erro saiu na resposta e voltou como informação de entrada. Repetido ou desenvolvido, pode sustentar novas suposições e dificultar a mudança de rumo. Isso não significa que cada repetição necessariamente aumente seu peso de atenção.
É nesse sentido que usamos “envenenamento de contexto”: informações enganosas produzidas durante a conversa prejudicam as respostas seguintes e travam a iteração. Não implica alteração dos parâmetros aprendidos no treinamento; o problema descrito está no uso do contexto durante a geração.
Uma conversa permite observar esse desvio, mas não medir os pesos internos de atenção nem provar sua causa exata. “Pontos de atenção” é nossa expressão informal para referências que continuam puxando a conversa para o rumo errado.
Uma ferramenta colaborativa deve distinguir o que você pediu, o que ela inferiu e o que já foi corrigido. E permitir que uma correção realmente mude a próxima resposta.
Se você já passou mais tempo corrigindo a conversa do que realizando sua tarefa, conte pelo espaço de relato privado do post. Qual interpretação continuou voltando, mesmo depois de você explicar?