Pides ayuda para explorar una idea.
La herramienta supone que quieres implementarla de inmediato. Pregunta por la arquitectura. Explicas que todavía estás investigando. Pide criterios de implementación. Corriges otra vez.
La idea sigue esperando. La conversación ya tiene un proyecto entero que nunca pediste.
Escena hipotética. Tal vez tu asunto fuera otro. El camino puede resultar familiar.
Cuando la suposición se convierte en el asunto
Una pregunta puede ayudar mucho. El problema empieza cuando arrastra una conclusión que todavía no se ha acordado.
Respondes para deshacer la conclusión. La herramienta interpreta la respuesta dentro de esa misma conclusión. Ahora necesita otra pregunta. Después, otra.
En cada ronda, el historial gana material sobre el camino equivocado. La tarea original ocupa unas pocas líneas; la discusión para recuperar la tarea ocupa páginas.
En este post, lo llamamos envenenamiento del contexto: un ciclo en el que las interpretaciones introducidas por el modelo pasan a orientar la conversación, dificultando la revisión de esas mismas interpretaciones.
No estamos hablando aquí de un ataque externo. Estamos hablando de una colaboración que se va quedando atrapada en lo que la herramienta añadió.
Más conversación, menos avance
Iterar es poder probar, recibir una respuesta y ajustar el rumbo. La persona puede descubrir lo que quiere mientras conversa.
Cuando cada ajuste se convierte en una nueva exigencia para justificar la petición, esa posibilidad se pierde. Tienes que convencer a la herramienta de que vuelva al punto de partida.
“Eso no es lo que pedí” debería permitir un cambio de rumbo. Si se convierte solo en una frase más añadida al historial, el error gana compañía en lugar de corregirse.
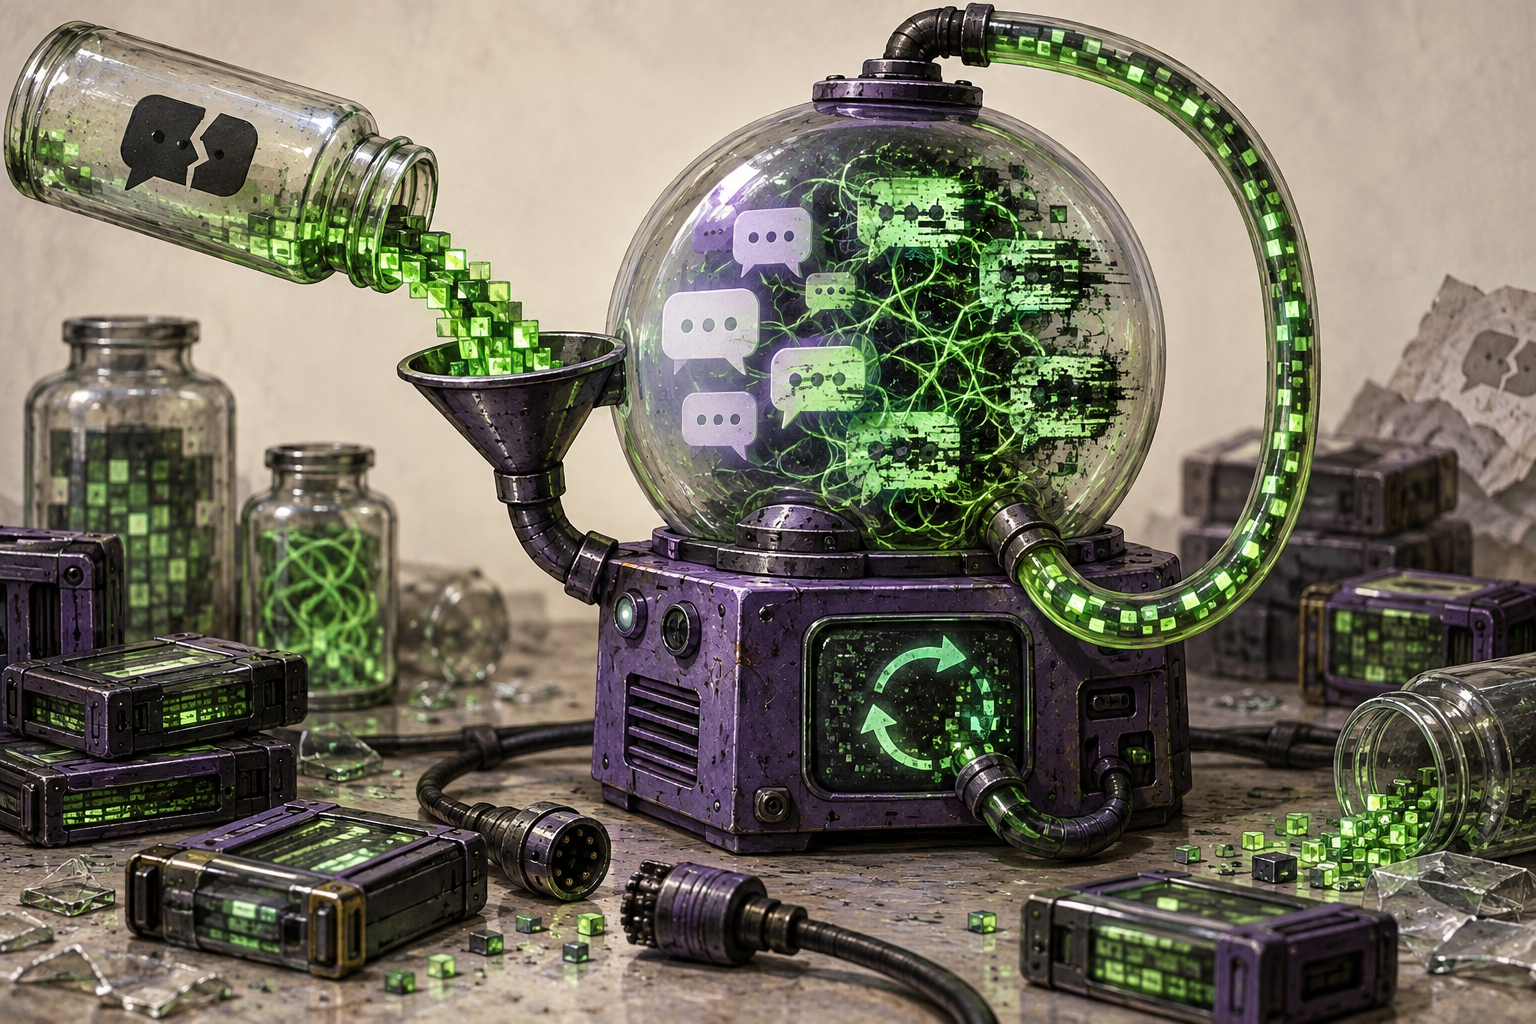
La máquina de la imagen recibe datos contaminados y los hace circular de nuevo. Esa es la metáfora: el contexto producido por la propia herramienta vuelve a alimentar sus siguientes respuestas.
La investigación encontró un problema cercano
Laban y colegas estudiaron tareas distribuidas en varias rondas de conversación. En los experimentos, los modelos probados hicieron con frecuencia suposiciones prematuras y se apoyaron demasiado en las soluciones generadas inicialmente, con dificultad para recuperar el rumbo. Es evidencia de un problema de fiabilidad conversacional; no demuestra que toda pregunta sea perjudicial ni reproduce exactamente la escena de este post. Lee LLMs Get Lost In Multi-Turn Conversation.
El resultado ayuda a formular una exigencia simple: una herramienta conversacional tiene que poder revisar lo que ella misma presumió.
Qué ocurre técnicamente, en lenguaje sencillo
El modelo no responde solo a tu última frase. En un chat, recibe un contexto: instrucciones, mensajes anteriores y otros materiales que incluya la aplicación. Piensa en ello como la mesa de trabajo disponible para elaborar la siguiente respuesta.
Ese texto se divide en pequeños fragmentos llamados tokens. En los modelos basados en Transformer, la self-attention relaciona esos fragmentos y combina información entre ellos. Así, los pasajes anteriores pueden influir en lo que se generará. La atención es un cálculo; no es una evaluación automática de la verdad. El mecanismo se presentó en Attention Is All You Need.
Este es el punto: una respuesta errónea del propio modelo puede volver como parte del contexto de la siguiente ronda. Pasa a estar en la mesa junto con la petición y con tu corrección.
Imagina que digas “quiero explorar posibilidades” y el modelo responda “vamos a preparar el lanzamiento”. Si esa interpretación sigue orientando las siguientes respuestas, la conversación pasa a girar en torno a un lanzamiento que no solicitaste.
El error salió en la respuesta y volvió como información de entrada. Repetido o desarrollado, puede sostener nuevas suposiciones y dificultar el cambio de rumbo. Esto no significa que cada repetición aumente necesariamente su peso de atención.
Es en este sentido en el que usamos “envenenamiento de contexto”: la información engañosa producida durante la conversación perjudica las respuestas siguientes y bloquea la iteración. No implica una alteración de los parámetros aprendidos en el entrenamiento; el problema descrito está en el uso del contexto durante la generación.
Una conversación permite observar esa desviación, pero no medir los pesos internos de atención ni demostrar su causa exacta. “Puntos de atención” es nuestra expresión informal para las referencias que siguen empujando la conversación hacia el rumbo equivocado.
Una herramienta colaborativa debe distinguir lo que pediste, lo que ella infirió y lo que ya se ha corregido. Y permitir que una corrección cambie realmente la siguiente respuesta.
Si ya has pasado más tiempo corrigiendo la conversación que realizando tu tarea, cuéntalo en el espacio de relato privado de la publicación. ¿Qué interpretación siguió volviendo, incluso después de que lo explicaras?