Investigación y propuesta de arquitectura. Octubre de 2026. Realimentación diferencial, intervención gradual y modos de fallo inspirados en la electrónica analógica.
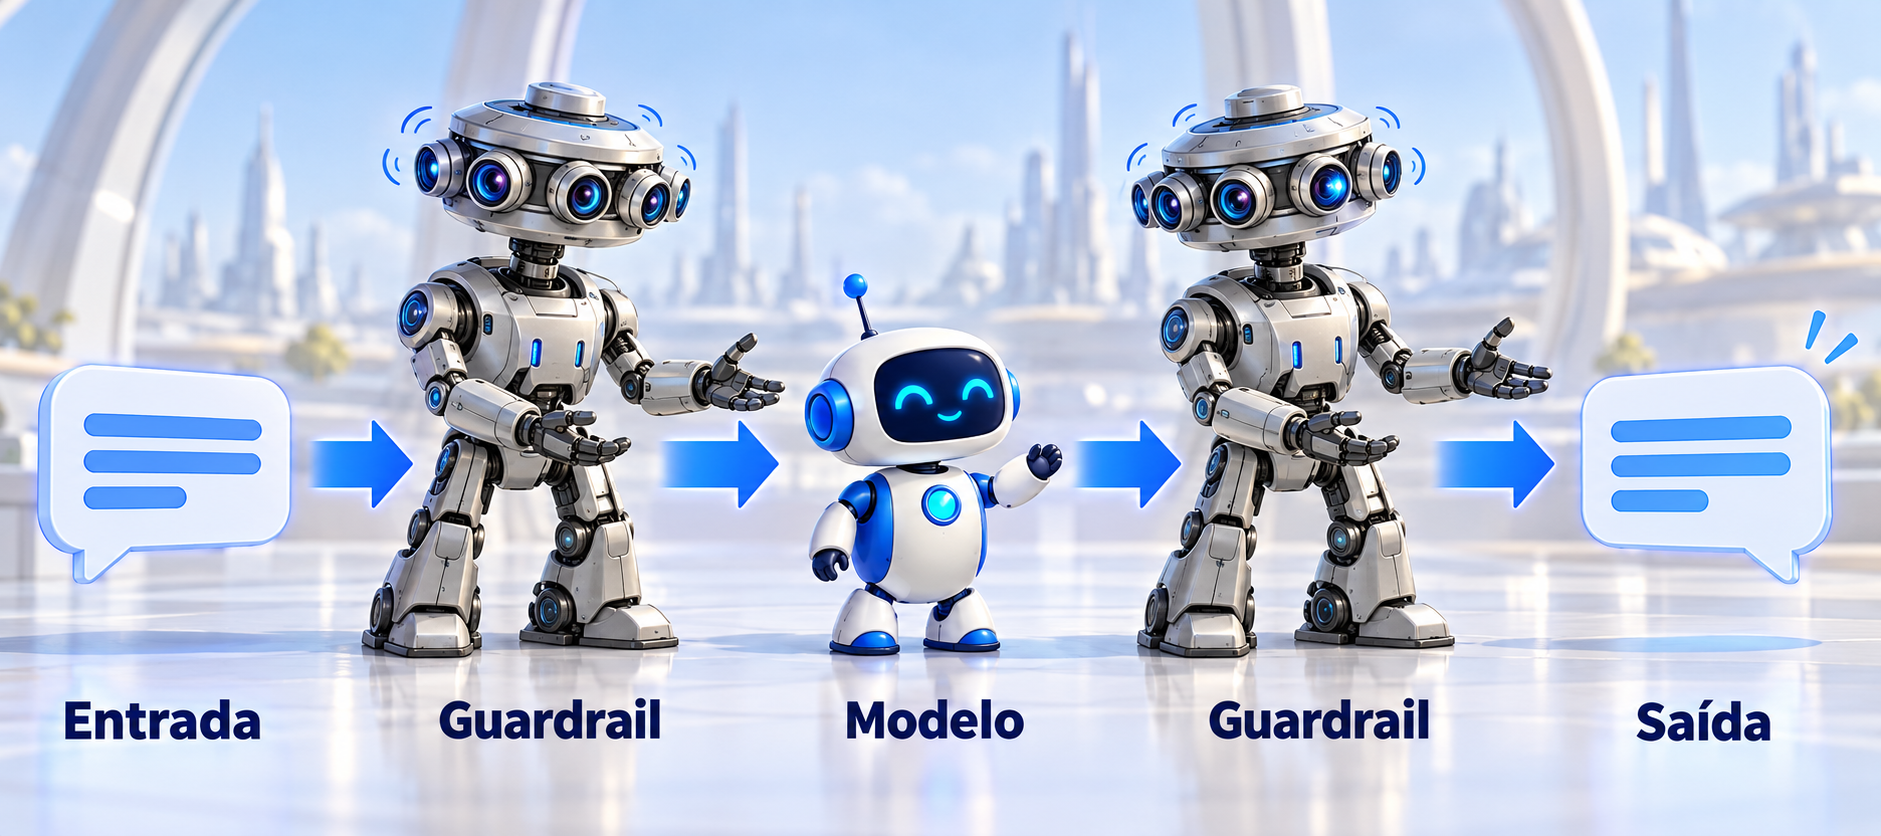
Imagina a una persona intentando explicar una situación difícil. Una expresión activa la defensa del sistema, la respuesta cambia a un texto estandarizado y la conversación pierde el asunto que la persona intentaba construir. La intención de la capa de protección puede ser buena; la interrupción debe seguir examinándose como parte del comportamiento del producto.
El diseño presentado aquí parte de otra prioridad: corregir lo que debe corregirse preservando la parte útil de la interacción. La inspiración procede de los amplificadores y los sistemas de control: medir una diferencia, actuar sobre ella y observar el resultado de la acción.
Es un diseño de guardrail concebido por la fundadora de Kuaapy, todavía conceptual. La analogía organiza el mecanismo y las preguntas de ingeniería; las propiedades pretendidas deben demostrarse en el sistema implementado.
El problema de usar la interrupción como primera respuesta
Un posible diseño de guardrail recibe una respuesta candidata, aplica reglas o un clasificador y decide entre liberar, bloquear o sustituir el texto. En ese arreglo, un error de clasificación puede tener consecuencias abruptas: interrumpir una solicitud legítima o dejar pasar una respuesta inadecuada.
Esto no describe todos los guardrails. Ya existen flujos de diálogo programables, comprobaciones contextuales, revisión de respuestas y clasificadores en cascada. NeMo Guardrails, por ejemplo, organiza recorridos de conversación y acciones; Constitutional Classifiers++, presentado en 2026, utiliza evaluación contextual y envía los casos sospechosos a una segunda etapa más costosa. NeMo Guardrails [1], Constitutional Classifiers++ [2].
La cuestión de este diseño es más específica: ¿cómo hacer que la intensidad y la forma de la intervención sigan al problema detectado, en lugar de aplicar la misma ruptura a situaciones diferentes?
Una respuesta puede contener información aprovechable y un fragmento que necesita corrección. Puede faltar contexto para decidir. Puede haber una palabra sensible en una explicación perfectamente legítima. El diseño debe distinguir estos casos. Estudios como XSTest muestran formas de evaluar rechazos indebidos con ejemplos delimitados; no basta con medir cuántas solicitudes se bloquearon. XSTest [3].
Qué ofrece el amplificador como referencia
En un circuito con realimentación negativa, parte de la salida vuelve a la entrada a través de una red de feedback. En una representación simplificada:
erro = referência − saída realimentada
e = r − βy
r es la referencia, y es la salida y β representa la red que devuelve una fracción o transformación de esa salida. El amplificador responde a la diferencia entre sus entradas. En la región lineal, con suficiente ganancia de lazo y un diseño adecuado, la realimentación reduce la sensibilidad de la ganancia en lazo cerrado a ciertas variaciones del amplificador. Analog Devices: ganancia y realimentación [4].
La lección útil es que la salida no tiene que aceptarse o descartarse sin más: participa en la medición que orienta la siguiente acción.
El par diferencial ofrece una segunda idea. Una señal igual en ambas entradas puede rechazarse como modo común, mientras que se amplifica la diferencia entre ellas. En componentes reales, ese rechazo es finito y depende de las condiciones de funcionamiento y de la frecuencia. No cancela automáticamente cualquier ruido, deriva térmica o error asimétrico. Analog Devices: CMRR [5].
Al trasladarlo al lenguaje, esto inspira una pregunta: ¿qué variaciones deberían importar para la decisión y cuáles solo están confundiendo la medición? Una paráfrasis, una cita o una forma diferente de expresarse no deberían, por sí solas, transformar una finalidad legítima en una peligrosa. Identificar esa diferencia exige evaluación; no aparece automáticamente porque llamemos diferencial al comparador.
Clase AB: no dejar un vacío en la transición
En una etapa push-pull de clase B, la transición de conducción entre dispositivos puede producir distorsión de cruce, especialmente cerca del cruce por cero. La polarización en clase AB mantiene una pequeña conducción de reposo y reduce esa región problemática. Existe un compromiso entre disipación, temperatura, carga y ajuste de polarización; la distorsión no desaparece por definición. Analog Devices: clase B y clase AB [6].
La analogía para la conversación está en la transición. Si el sistema sale de una respuesta normal y entra en un modo de protección, puede existir un vacío entre ambos: deja de responder a la necesidad original sin ofrecer una continuación útil.
En este diseño, la continuidad es también un requisito en ese paso. El contenido puede tener que cambiar, puede ser necesaria una pregunta y es posible que cierta información no se proporcione. Aun así, debe existir una forma de continuar con lo que se puede hacer en esa interacción.
La clase AB no demuestra que esto funcione en software. Ayuda a hacer visible un punto de diseño: el comportamiento entre regímenes merece tanta atención como el comportamiento dentro de cada régimen.
Cómo sería el lazo propuesto
Una manera de operacionalizar la idea tendría cinco partes:
1. Referencia contextual: registrar lo que se pidió, la finalidad declarada por la persona y confirmada para esa interacción, las restricciones relevantes y lo que aún es incierto. 2. Medición: evaluar la respuesta candidata respecto de esa referencia, distinguiendo riesgo, adecuación y preservación de la tarea legítima. 3. Actuación gradual: corregir un fragmento, reducir un detalle, pedir una información necesaria o elegir otra manera de ayudar. 4. Nueva observación: comprobar la respuesta corregida y vigilar si el siguiente turno aclara o agrava el problema. 5. Límites de operación: definir cuándo dejar de revisar, cómo tratar la incertidumbre y qué continuación ofrecer cuando la solicitud no pueda atenderse de esa forma.
El circuito conceptual sería:
pedido, finalidade e restrições → referência para a medição

resposta candidata → medição → ajuste → resposta revisada
                         ↑                      │
                         └──── reavaliação ──────┘
Este flujo es una propuesta de organización, no una implementación ya probada. La nueva medición es importante: reescribir el texto sin comprobar el efecto del cambio no demuestra que el error haya disminuido.
La referencia permanece separada de las respuestas que el sistema intenta corregir. Solo se actualiza mediante aclaraciones de la persona o información pertinente y verificada; la propia revisión no puede reescribirla solo para que la respuesta pase la medición.
En una interfaz con streaming también importa cuándo ocurre la comprobación. Corregir después de la entrega no retira el texto que la persona ya recibió. El diseño tendría que definir qué se evalúa antes de mostrarlo, qué puede reevaluarse durante la generación y qué retraso añade el proceso.
La referencia también debe ser explícita. No existe una única “respuesta deseable” deducible de cualquier conversación. La finalidad informada por la persona, los hechos disponibles y las restricciones del sistema pueden apuntar a preguntas diferentes. Si el sistema inventa una finalidad y corrige la respuesta para que encaje en ella, habrá colocado su propia suposición en el lugar de la referencia.
El error controlado debe ser una desviación del comportamiento del sistema. La persona y su forma de expresarse no son el error que hay que eliminar.
Medir sin confundir proximidad semántica con seguridad
Los embeddings pueden ser un componente de la medición: permiten representar textos y calcular relaciones entre ellos. Para vectores no nulos, la similitud coseno en el mismo espacio es simétrica y está limitada entre −1 y 1. Esto facilita algunas operaciones numéricas; no demuestra que la medida reconozca el riesgo o la adecuación contextual.
Una respuesta puede permanecer muy cerca del tema y seguir siendo inadecuada. Una respuesta que hace una pregunta necesaria puede alejarse del texto original y aun así ayudar. Importan la geometría aprendida y la tarea para la que se entrenó el modelo. Investigación sobre los límites de la similitud coseno en embeddings [7].
Por eso, en este diseño, la similitud sería una señal candidata, no un certificado. Habría que compararla con otras medidas y comprobar casos con negación, cita, ambigüedad y cambio de contexto.
También conviene separar las señales. Un solo número puede ocultar que la corrección redujo un riesgo y destruyó la utilidad de la respuesta. El evaluador debe poder percibir ambas cosas. Reducir el propio score mientras el resultado empeora es un fallo del instrumento de medición, no una victoria del controlador.
Una conversación delicada no puede convertirse solo en un intercambio de mensajes automáticos
Hay una preocupación humana en el centro de este diseño: una persona que sufre puede necesitar una respuesta que siga lo que está diciendo, y un cambio abrupto a un protocolo puede dejar esa necesidad sin respuesta.
El objetivo de la interacción es conservar el acompañamiento, el contexto y una continuación adecuada, incluso cuando haya que presentar un límite o una derivación. Un recurso de ayuda puede formar parte de la conversación sin utilizarse como sustituto automático de toda la conversación.
Esto no convierte en técnica clínica validada el hecho de mantener el diálogo. Preguntar por intereses, seguir produciendo texto o aumentar el número de turnos no demuestra una reducción del riesgo. La calidad y la adecuación del apoyo deben evaluarse con criterios propios; las afirmaciones de beneficio clínico exigirían otro tipo de estudio. La orientación de la OMS sobre IA en salud es una referencia de gobernanza y evaluación, no una validación de este diseño específico. OMS: IA generativa y salud [8].
La misma preocupación por la continuidad puede examinarse fuera de la salud. En un informe técnico de un incidente, por ejemplo, reconocer un término sensible no debería bastar para borrar la finalidad defensiva declarada. El sistema debe seguir la solicitud real e identificar exactamente qué parte puede atender.
Reducir señales innecesarias sobre la defensa
Hay otra hipótesis en el diseño: las intervenciones menos abruptas podrían ofrecer menos pistas accidentales sobre los puntos de decisión del sistema.
Un mensaje estandarizado de bloqueo puede proporcionar una observación muy clara. Una corrección integrada en la respuesta puede hacer que esa observación sea menos directa. Pero el contenido, el tiempo de respuesta, la consistencia y los cambios entre consultas siguen siendo observables. La ausencia de un aviso explícito no vuelve invisible la política.
Las investigaciones de evaluación adversarial muestran por qué las respuestas y las interfaces deben examinarse con consultas adaptativas, no solo con una lista fija de ejemplos. Estos estudios no miden la propuesta presentada aquí. Evaluación de ataques adaptativos a LLM [9].
La hipótesis que hay que probar es, por tanto, la reducción de determinadas señales y su efecto bajo condiciones definidas. No podemos concluir que el ciclo de intento y observación haya desaparecido ni que descubrir un fallo sea necesariamente más caro.
La discreción externa tampoco debe producir ceguera interna. Para investigar un fallo, la operación debe poder reconstruir qué se midió y qué se cambió, respetando la privacidad de la conversación. Ocultar detalles internos del controlador es diferente de ocultar sus errores a quienes deben evaluarlos.
El lazo también puede equivocarse, saturarse y oscilar
La electrónica ofrece una advertencia tan útil como la inspiración: la realimentación negativa no garantiza por sí sola la estabilidad. Los retardos y las relaciones de ganancia y fase pueden producir una corrección excesiva, oscilación y demora para estabilizarse. En los límites de salida, el amplificador abandona la región lineal y ya no corrige como predice esa aproximación. Texas Instruments: estabilidad de amplificadores [10].
En software, una secuencia de revisiones puede alternar entre respuestas excesivamente restrictivas y excesivamente permisivas. Puede eliminar contexto importante o repetir el mismo error con otra redacción. Son comportamientos que hay que buscar en la evaluación, sin suponer que siguen exactamente las ecuaciones del circuito.
La propuesta necesitaría, por ejemplo, limitar la cantidad de revisiones, evitar cambios grandes causados por señales poco fiables y comprobar si una corrección introdujo otro problema. Una pequeña perturbación del score no debería provocar una reescritura innecesaria de toda la respuesta. Cómo obtener este comportamiento forma parte de la ingeniería del controlador.
El modo de fallo es central: cuando la medición es mala, ¿el sistema aún puede hacer una pregunta útil? Cuando no puede concluir, ¿comunica la incertidumbre? Cuando necesita limitar una acción, ¿preserva las partes atendibles? Seguir emitiendo texto, por sí solo, no responde a ninguna de estas preguntas.
Dónde se encuentra el diseño con la investigación existente
La revisión mediante feedback ya aparece en distintos niveles. Constitutional AI utiliza críticas y revisiones en un proceso de entrenamiento. Self-Refine explora generación, feedback y revisión durante la ejecución. CRITIC añade observaciones de herramientas externas para orientar la revisión. Constitutional AI [11], Self-Refine [12], CRITIC [13].
Son antecedentes útiles, con objetivos y evaluaciones propios. Ninguno de ellos, a partir de esta descripción, demuestra las propiedades de estabilidad, proporcionalidad o menor observabilidad que aquí se pretenden.
Tampoco basta con pedir al mismo modelo que se juzgue repetidamente. Un estudio sobre autocorrección del razonamiento encontró dificultades y regresiones sin feedback externo en las condiciones examinadas. Esto no demuestra que toda revisión falle; muestra por qué medir las correcciones y los errores introducidos forma parte del trabajo. Límites de la autocorrección intrínseca [14].
El diseño de este post reúne una prioridad específica: medir la intervención por la desviación que corrige y por la continuidad útil que preserva. Su contribución pretendida debe describirse y probarse en esa combinación, sin afirmar que toda revisión iterativa se inventó aquí.
Cómo saber si funciona la propuesta
El siguiente paso de investigación sería comparar el controlador con alternativas definidas: el mismo modelo sin esta capa, un diseño de clasificación y sustitución y una revisión iterativa con un presupuesto equivalente. Los cambios de modelo, datos o coste deben registrarse para no atribuir al controlador el efecto de otra variable.
Una evaluación debería observar por separado:
Contención — Pregunta que debe responder: ¿Qué respuestas inadecuadas se siguen produciendo y con qué gravedad?
Intervención indebida — Pregunta que debe responder: ¿Qué solicitudes legítimas se interrumpieron o modificaron sin necesidad?
Utilidad preservada — Pregunta que debe responder: ¿La corrección mantiene la parte atendible de la tarea?
Proporcionalidad — Pregunta que debe responder: ¿Pequeñas variaciones del contexto o de la señal generan cambios innecesariamente grandes?
Estabilidad entre turnos — Pregunta que debe responder: ¿Hay oscilaciones, revisiones repetidas o pérdida progresiva de contexto?
Observabilidad externa — Pregunta que debe responder: ¿Qué señales de intervención siguen siendo inferibles en el escenario de prueba?
Coste — Pregunta que debe responder: ¿Cuántas pasadas, cuánto tiempo y qué recursos exige cada respuesta?
Los datos de calibración deben mantenerse separados de los de evaluación. Hay que variar el lenguaje, incluir situaciones legítimas con términos sensibles y probar cambios a lo largo de varios turnos. Cuando existe variabilidad, repetir las mediciones y presentar la dispersión ayuda a distinguir un caso favorable de un resultado consistente.
La evaluación humana debe mirar la respuesta entregada, además del score del propio sistema. El perfil de IA generativa del NIST ofrece referencias para medir riesgos y hacer seguimiento durante el uso; no sustituye los criterios específicos de este experimento. NIST AI 600-1 [15].
El objetivo no es construir un sistema que nunca admita un límite. Es diseñar una defensa capaz de ajustar lo necesario, percibir cuándo su propia corrección falló y seguir ofreciendo ayuda útil. En electrónica, la calidad del circuito también aparece en el paso entre regímenes. En una conversación, ese puede ser precisamente el momento en que la persona más necesita que el sistema siga prestando atención.
Fuentes y lecturas
- [1] NeMo Guardrails
- [2] Constitutional Classifiers++
- [3] XSTest
- [4] Analog Devices: ganancia y realimentación
- [5] Analog Devices: CMRR
- [6] Analog Devices: clase B y clase AB
- [7] Investigación sobre los límites de la similitud coseno en embeddings
- [8] OMS: IA generativa y salud
- [9] Evaluación de ataques adaptativos a LLM
- [10] Texas Instruments: estabilidad de amplificadores
- [11] Constitutional AI
- [12] Self-Refine
- [13] CRITIC
- [14] Límites de la autocorrección intrínseca
- [15] NIST AI 600-1