Cómo BPE, Unigram y la preparación del texto cambian la representación de código y portugués — con ejemplos medidos.
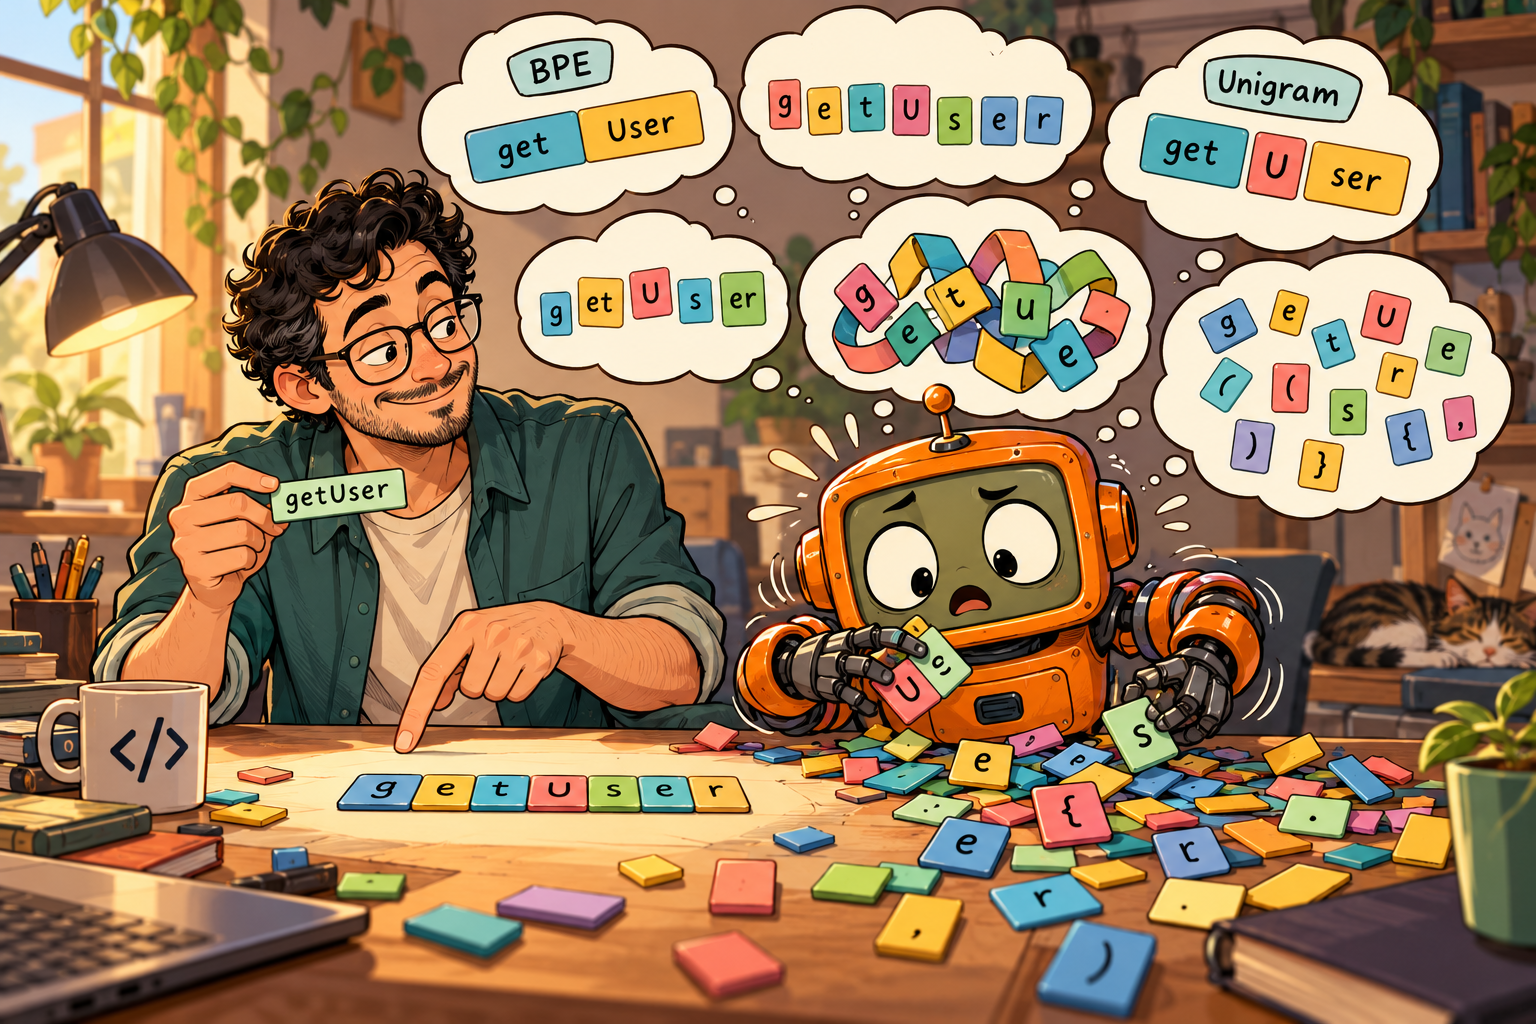
Antes de recibir una pregunta, un modelo de lenguaje basado en tokens recibe una secuencia de números. Entre la frase escrita y esos números hay una decisión de ingeniería: cómo dividir el texto y asociar cada parte con un ID.
Esa elección determina cuántas posiciones ocupa el texto en la entrada y qué unidades llegan a la capa de embeddings. Una función de programación puede convertirse en una secuencia corta en una configuración y en una secuencia mucho más larga en otra. Para quienes trabajan con documentos extensos, código o portugués, conviene observar esta diferencia antes de atribuir todo resultado al tamaño del modelo.
Para hacer concreta la discusión, entrenamos dos tokenizadores pequeños con el mismo corpus sintético y registramos las segmentaciones. No entrenamos un LLM: el experimento mide representación, no capacidad de programar.
1. Qué es un token — y qué no necesita ser
Un token puede representar una palabra, una parte de una palabra, puntuación, espacios o bytes. El vocabulario relaciona esas unidades con IDs. Después, el modelo transforma los IDs en vectores aprendidos durante el entrenamiento.
Un límite entre tokens no tiene que coincidir con un límite entre palabras, morfemas o elementos de sintaxis de un lenguaje de programación. Tampoco es necesario que cada parte tenga un significado aislado para que el modelo aprenda relaciones entre ellas.
Por eso, la expresión “el modelo piensa en tokens” funciona como una simplificación, pero no describe todo el procesamiento. Los tokens son la representación discreta de entrada y salida; el cálculo interno incluye vectores y transformaciones aprendidas.
2. SentencePiece no es lo contrario de BPE
SentencePiece es una herramienta que implementa diferentes algoritmos, incluidos BPE y Unigram. Para comparar enfoques, debemos identificar el algoritmo y sus configuraciones, no solo el nombre de la biblioteca. Artículo de SentencePiece [1].
BPE — Cómo produce la segmentación: Aprende una secuencia de fusiones de símbolos frecuentes y luego aplica esas reglas al texto.; Distinción importante: Las unidades iniciales pueden ser caracteres o bytes, según la variante.
Unigram — Cómo produce la segmentación: Aprende probabilidades para piezas de un vocabulario y evalúa caminos de segmentación.; Distinción importante: Puede elegir el mejor camino de forma determinista o muestrear alternativas.
WordPiece — Cómo produce la segmentación: En la implementación de BERT, busca de forma codiciosa la pieza disponible más larga en cada posición.; Distinción importante: Las piezas no son morfemas garantizados.
En la adaptación de BPE para traducción neuronal, Sennrich y sus colegas trabajaron con secuencias de caracteres de longitud variable. Byte-level BPE es otra configuración posible; el nombre BPE no implica que toda implementación comience por bytes. BPE aplicado a subpalabras [2].
El modelo probabilístico Unigram tampoco significa que la misma frase deba dividirse aleatoriamente en cada uso. El muestreo de segmentaciones puede utilizarse como regularización durante el entrenamiento. Subword Regularization [3].
En el WordPiece de BERT, el marcador ## indica continuación de una palabra. El algoritmo usa un vocabulario y una búsqueda longest-match-first; eso no equivale a analizar la morfología del idioma. Implementación oficial [4].
3. Un identificador, dos segmentaciones reales
Considera este nombre de función:
getUserAuthenticationTokenEn los dos tokenizadores de nuestro ensayo, el resultado fue:
BPE — 5 tokens
[g] [et] [User] [Authentication] [Token]

Unigram — 12 tokens
[g] [e] [t] [U] [se] [r] [Authentication] [T] [o] [k] [e] [n]
Los corchetes se añadieron para visualizar los límites; no forman parte del texto. Son las piezas que la biblioteca devolvió efectivamente, no una segmentación imaginada para ilustrar el argumento.
En ambos casos reconstruimos exactamente getUserAuthenticationToken. La diferencia es el número de unidades usadas para representarlo. En este ejemplo, BPE produce una secuencia más corta. Esto no demuestra que un LLM con ese tokenizador entendería mejor la función.
Hay otro detalle revelador: el prefijo get no se utilizó como uno de los verbos generadores del corpus de entrenamiento. El resultado depende de las piezas que los algoritmos pudieron aprender de ese material. Un tokenizador comercial, entrenado con otro corpus y un vocabulario mayor, puede producir cortes distintos.
4. La diferencia también aparece en la dirección contraria
No basta con elegir un identificador favorable a un enfoque. Incluimos fragmentos de lenguajes distintos y un documento JSON:
const sessionKey = getUserAuthenticationToken(user.id);let result = items.iter().map(|item| item.id).collect::<Vec<_>>();def validar_sessao(usuario):
return usuario.esta_ativo and usuario.tem_permissao{"ação":"renovar","usuário":"João","válido":true}Identificador aislado — BPE: 5; Unigram: 12
Línea de TypeScript — BPE: 16; Unigram: 24
Línea de Rust — BPE: 45; Unigram: 53
Función Python, incluyendo salto de línea e indentación — BPE: 57; Unigram: 55
JSON con acentos — BPE: 41; Unigram: 41
El ejemplo de Python fue más corto con Unigram; el JSON empató. La conclusión demostrada es que los algoritmos aprenden representaciones diferentes y que la relación de longitud cambia según la entrada. Aquí no encontramos una regla universal de superioridad.
Un tokenizador tampoco es un compilador. En Rust, :: y => cumplen funciones en la sintaxis del lenguaje; los límites de los tokens del modelo no tienen que coincidir con los tokens de un lexer. Para investigar la estructura sintáctica, habría que comparar la segmentación con un análisis independiente del programa. Referencia de expresiones de Rust [5].
Cómo hicimos la comparación
Usamos SentencePiece 0.2.1, con BPE y Unigram entrenados por separado en el mismo corpus sintético de 2.620 líneas. Cada vocabulario tiene 512 entradas, incluidas las piezas de byte fallback y el token desconocido. Mantuvimos la normalización identity, la preservación de espacios, las mismas reglas de separación y un hilo. No añadimos BOS, EOS ni PAD a las entradas.
El corpus contiene 2.304 líneas generadas a partir de patrones de código, 216 frases en portugués y 100 en inglés. Es pequeño, artificial y está dominado por código: no representa la distribución de un repositorio real ni de un idioma. Las once entradas de evaluación se definieron antes del entrenamiento y no aparecen íntegramente en el corpus.
Comprobamos 22 reconstrucciones exactas, once por tokenizador. Cinco recodificaciones de cada entrada produjeron los mismos IDs. Esto verifica la estabilidad de la codificación en esta ejecución; no son cinco entrenamientos independientes ni una evaluación de la variación de calidad.
El script, el corpus, las configuraciones, los archivos de los tokenizadores, los IDs y las piezas de todas las entradas se conservan con los resultados. Los números anteriores se refieren únicamente a esos artefactos. Herramienta y documentación [6].
5. Portugués: medir el coste sin inventar una regla universal
Una secuencia más fragmentada puede consumir más posiciones de contexto para transportar un contenido equivalente. En servicios cobrados por token, esto también puede afectar al precio. Pero no es correcto afirmar que toda frase en portugués tendrá más tokens que su traducción al inglés.
Petrov y sus colegas compararon textos paralelos de distintos idiomas y encontraron disparidades importantes entre tokenizadores. El diseño usa contenido correspondiente, lo que permite investigar el coste de representación entre lenguas. Los resultados pertenecen a los tokenizadores y datos evaluados; no son una tasa fija para cualquier producto actual. Language Model Tokenizers Introduce Unfairness Between Languages [7].
En nuestro ensayo, la frase A responsabilização exige documentação compreensível. ocupó 28 tokens en BPE y 31 en Unigram. Esto muestra la diferencia entre los dos artefactos entrenados. No mide por sí solo una desventaja del portugués frente a otra lengua.
Para esa comparación necesitamos traducciones alineadas, muestras de géneros variados y estadísticas por documento. Los tokens por carácter miden una característica de compactación de la escritura; los tokens por traducción equivalente responden a otra pregunta. Ninguna de estas medidas, por sí sola, informa cuánto comprendió el modelo.
6. Byte fallback cubre caracteres; la normalización decide qué preservar
Cuando está habilitado en SentencePiece, byte fallback permite representar caracteres fuera de las piezas habituales mediante sus bytes UTF-8. Es una opción de configuración, no una propiedad automática de todo tokenizador. Opciones oficiales [8].
Esto no elimina la necesidad de examinar la normalización. Los cambios de mayúsculas, acentos, espacios o formas Unicode pueden ocurrir antes de la segmentación, según el pipeline. Un mecanismo capaz de representar todos los bytes aún puede recibir un texto ya transformado.
Incluimos café y cafe\u0301, la segunda forma escrita con un acento combinante. Con la normalización identity del ensayo, las dos formas utilizaron respectivamente 5 y 6 tokens en ambos algoritmos y volvieron a las secuencias originales. Una apariencia similar en pantalla no significa que los caracteres o bytes sean idénticos.
En código, los espacios, tabulaciones y saltos de línea también deben verificarse. En el ejemplo de Python, preservar la indentación es un requisito de fidelidad del texto, no un detalle de presentación.
7. Menos tokens no significa automáticamente más capacidad
Una secuencia más corta puede permitir más contenido dentro del mismo límite de entrada. Sin embargo, el coste computacional depende de la arquitectura, la longitud, la implementación de la atención y el hardware. No existe una conversión universal de “menos tokens” a “tantas veces más rápido”.
Hay evidencia experimental de que la elección del tokenizador afecta al desempeño de modelos entrenados. Rust y sus colegas investigaron modelos multilingües y alternativas monolingües en nueve idiomas y cinco tareas. Ali y sus colegas estudiaron la elección de tokenizadores en modelos decoder-only, controlando las condiciones de entrenamiento. Son evaluaciones downstream, distintas de nuestra demostración de segmentación. Rust et al. [9], Ali et al. [10].
La literatura también examina por qué la compactación, por sí sola, no basta para caracterizar un tokenizador. Tokenization Is More Than Compression [11].
La misma cautela vale para identificar modelos. Una segmentación aislada no funciona como una huella inequívoca del origen de los pesos. Y cambiar el tokenizador de un modelo listo exige respetar la correspondencia entre IDs, embeddings y salida: no es un cambio de archivo que conserve automáticamente el comportamiento.
Qué llevar a un proyecto real
Conviene registrar el algoritmo, el vocabulario, los tokens especiales, la normalización y la revisión de los archivos junto con el modelo. En tiktoken, por ejemplo, el nombre del encoding y la versión del paquete son informaciones distintas; la preparación mediante expresiones regulares también participa en el resultado. Implementación y encodings [12].
Para comenzar una evaluación podemos separar dos etapas:
1. Representación: medir segmentación, longitud y reconstrucción en código, textos en portugués, Unicode y espacios, y divulgar el corpus y los artefactos. 2. Capacidad: comparar modelos entrenados bajo condiciones controladas, con tareas de programación y lenguaje, repeticiones y registro de regresiones.
El primer paso muestra diferencias reales como las de este artículo. El segundo es necesario para afirmar que una elección mejoró el razonamiento, la comprensión o la programación.
Para Kuaapy, esta distinción forma parte de la accesibilidad: el idioma y la forma de escribir de una persona no deberían tratarse como obstáculos invisibles. Investigar cuánto contexto y esfuerzo exige cada representación es una forma concreta de hacer visibles esos costes.
Fuentes y materiales para profundizar
Guías prácticas y herramientas oficiales
• SentencePiece — código, instalación y ejemplos [6]: punto de partida para entrenar y utilizar los algoritmos de la herramienta.
• Opciones de SentencePiece [8]: configuraciones de entrenamiento, vocabulario y byte fallback.
• Pipeline de tokenización — Hugging Face [13]: normalización, pre-tokenización, modelo y posprocesamiento.
• Componentes de un tokenizador — Hugging Face [14]: funciones de las piezas que componen el pipeline.
• tiktoken — repositorio oficial [15]: implementación BPE y ejemplos de codificación y decodificación.
Papers y estudios citados
• BPE para traducción neuronal — Sennrich, Haddow y Birch [2].
• Subword Regularization — Kudo [3].
• SentencePiece — Kudo y Richardson [1] y repositorio oficial [6].
• Tokenización de BERT [4].
• tiktoken [15].
• Evaluación multilingüe — Rust et al. [9].
• Desigualdad entre idiomas — Petrov et al. [7].
• Elección de tokenizadores durante el entrenamiento — Ali et al. [10].
• Tokenization Is More Than Compression [11].
Investigación documental y ensayo local realizados el 23/10/2026. El ensayo utiliza tokenizadores didácticos propios; ningún resultado se midió en un LLM comercial.
Fuentes y lecturas
- [1] Artículo de SentencePiece
- [2] BPE aplicado a subpalabras
- [3] Subword Regularization
- [4] Implementación oficial
- [5] Referencia de expresiones de Rust
- [6] Herramienta y documentación
- [7] Language Model Tokenizers Introduce Unfairness Between Languages
- [8] Opciones oficiales
- [9] Rust et al.
- [10] Ali et al.
- [11] Tokenization Is More Than Compression
- [12] Implementación y encodings
- [13] Pipeline de tokenización — Hugging Face
- [14] Componentes de un tokenizador — Hugging Face
- [15] tiktoken — repositorio oficial