Como BPE, Unigram e a preparação do texto mudam a representação de código e português — com exemplos medidos.
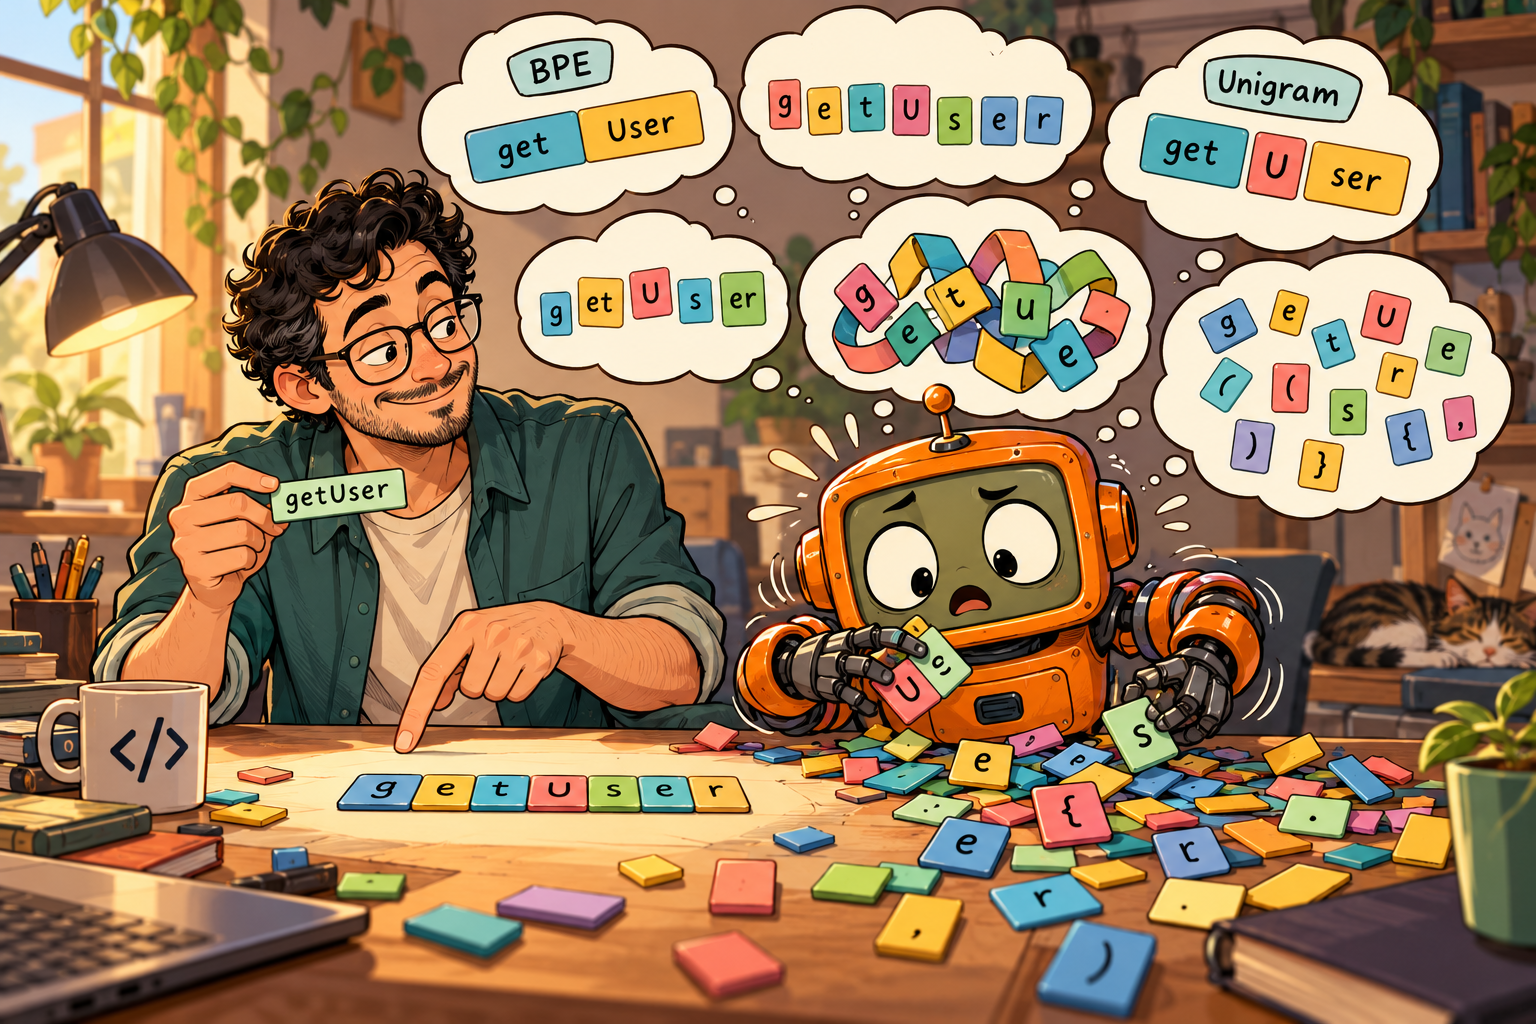
Antes de receber uma pergunta, um modelo de linguagem baseado em tokens recebe uma sequência de números. Entre a frase escrita e esses números existe uma decisão de engenharia: como dividir o texto e associar cada parte a um ID.
Essa escolha determina quantas posições o texto ocupa na entrada e quais unidades chegam à camada de embeddings. Uma função de programação pode virar uma sequência curta em uma configuração e uma sequência bem maior em outra. Para quem trabalha com documentos longos, código ou português, vale olhar para essa diferença antes de atribuir todo resultado ao tamanho do modelo.
Para tornar a discussão concreta, treinamos dois pequenos tokenizadores no mesmo corpus sintético e registramos as segmentações. Não treinamos uma LLM: o experimento mede representação, não capacidade de programar.
1. O que é um token — e o que ele não precisa ser
Um token pode representar uma palavra, um pedaço de palavra, pontuação, espaços ou bytes. O vocabulário relaciona essas unidades a IDs. Depois, o modelo transforma os IDs em vetores aprendidos durante o treinamento.
Uma fronteira entre tokens não precisa coincidir com uma fronteira entre palavras, morfemas ou elementos de sintaxe de uma linguagem de programação. Também não é necessário que cada parte tenha um significado isolado para que o modelo aprenda relações entre elas.
Por isso, a expressão “o modelo pensa em tokens” funciona como uma simplificação, mas não descreve todo o processamento. Os tokens são a representação discreta de entrada e saída; a computação interna envolve vetores e transformações aprendidas.
2. SentencePiece não é o oposto de BPE
SentencePiece é uma ferramenta que implementa diferentes algoritmos, incluindo BPE e Unigram. Para comparar abordagens, precisamos identificar o algoritmo e suas configurações, não apenas o nome da biblioteca. Paper SentencePiece [1].
BPE — Como produz a segmentação: Aprende uma sequência de fusões de símbolos frequentes; depois aplica essas regras ao texto.; Distinção importante: As unidades iniciais podem ser caracteres ou bytes, conforme a variante.
Unigram — Como produz a segmentação: Aprende probabilidades para peças de um vocabulário e avalia caminhos de segmentação.; Distinção importante: Pode escolher o melhor caminho de forma determinística ou amostrar alternativas.
WordPiece — Como produz a segmentação: Na implementação do BERT, procura de forma gulosa a maior peça disponível a cada posição.; Distinção importante: As peças não são morfemas garantidos.
Na adaptação de BPE para tradução neural, Sennrich e colegas trabalharam com sequências de caracteres de comprimento variável. Byte-level BPE é outra configuração possível; o nome BPE não implica que toda implementação comece por bytes. BPE aplicado a subpalavras [2].
O modelo probabilístico Unigram também não significa que a mesma frase precise ser dividida aleatoriamente a cada uso. A amostragem de segmentações pode ser usada como regularização durante o treinamento. Subword Regularization [3].
No WordPiece do BERT, o marcador ## indica continuação de palavra. O algoritmo usa um vocabulário e uma busca longest-match-first; isso não equivale a analisar a morfologia da língua. Implementação oficial [4].
3. Um identificador, duas segmentações reais
Considere este nome de função:
getUserAuthenticationTokenNos dois tokenizadores do nosso ensaio, o resultado foi:
BPE — 5 tokens
[g] [et] [User] [Authentication] [Token]

Unigram — 12 tokens
[g] [e] [t] [U] [se] [r] [Authentication] [T] [o] [k] [e] [n]
Os colchetes foram acrescentados para visualizar os limites; não fazem parte do texto. Essas são as peças efetivamente devolvidas pela biblioteca, não uma segmentação imaginada para ilustrar o argumento.
Nos dois casos, reconstruímos exatamente getUserAuthenticationToken. A diferença é o número de unidades usadas para representá-lo. Neste exemplo, o BPE produz uma sequência menor. Isso não demonstra que uma LLM com esse tokenizador entenderia melhor a função.
Há outro detalhe revelador: o prefixo get não foi usado como um dos verbos geradores do corpus de treino. O resultado depende das peças que os algoritmos puderam aprender naquele material. Um tokenizador comercial, treinado em outro corpus e com um vocabulário maior, pode produzir cortes diferentes.
4. A diferença também aparece na direção contrária
Não basta escolher um identificador favorável a uma abordagem. Incluímos trechos de linguagens diferentes e um documento JSON:
const sessionKey = getUserAuthenticationToken(user.id);let result = items.iter().map(|item| item.id).collect::<Vec<_>>();def validar_sessao(usuario):
return usuario.esta_ativo and usuario.tem_permissao{"ação":"renovar","usuário":"João","válido":true}Identificador isolado — BPE: 5; Unigram: 12
Linha TypeScript — BPE: 16; Unigram: 24
Linha Rust — BPE: 45; Unigram: 53
Função Python, incluindo quebra de linha e indentação — BPE: 57; Unigram: 55
JSON com acentos — BPE: 41; Unigram: 41
O exemplo Python ficou menor com Unigram; o JSON empatou. A conclusão demonstrada é que os algoritmos aprendem representações diferentes e que a relação de comprimento muda conforme a entrada. Não encontramos aqui uma regra universal de superioridade.
Um tokenizador também não é um compilador. Em Rust, :: e => têm funções na sintaxe da linguagem; os limites dos tokens do modelo não precisam coincidir com os tokens de um lexer. Para investigar estrutura sintática, seria necessário comparar a segmentação com uma análise independente do programa. Referência de expressões Rust [5].
Como fizemos a comparação
Usamos SentencePiece 0.2.1, com BPE e Unigram treinados separadamente no mesmo corpus sintético de 2.620 linhas. Cada vocabulário tem 512 entradas, incluindo as peças de byte fallback e o token desconhecido. Mantivemos normalização identity, preservação de espaços, as mesmas regras de separação e uma thread. Não acrescentamos BOS, EOS ou PAD às entradas.
O corpus contém 2.304 linhas geradas a partir de padrões de código, 216 frases em português e 100 em inglês. É pequeno, artificial e dominado por código: não representa a distribuição de um repositório real nem de um idioma. As onze entradas de avaliação foram definidas antes do treinamento e não aparecem integralmente no corpus.
Conferimos 22 reconstruções exatas, onze por tokenizador. Cinco recodificações de cada entrada produziram os mesmos IDs. Isso verifica estabilidade da codificação nesta execução; não são cinco treinamentos independentes nem uma avaliação de variância de qualidade.
O script, o corpus, as configurações, os arquivos dos tokenizadores, os IDs e as peças de todas as entradas estão preservados com os resultados. Os números acima se referem somente a esses artefatos. Ferramenta e documentação [6].
5. Português: medir o custo sem inventar uma regra universal
Uma sequência mais fragmentada pode consumir mais posições de contexto para transportar um conteúdo equivalente. Em serviços cobrados por token, isso também pode afetar o preço. Mas não é correto afirmar que toda frase em português terá mais tokens que sua tradução em inglês.
Petrov e colegas compararam textos paralelos de diferentes idiomas e encontraram disparidades importantes entre tokenizadores. O desenho usa conteúdo correspondente, permitindo investigar o custo de representação entre línguas. Os resultados pertencem aos tokenizadores e dados avaliados; não são uma taxa fixa para qualquer produto atual. Language Model Tokenizers Introduce Unfairness Between Languages [7].
No nosso ensaio, a frase A responsabilização exige documentação compreensível. ocupou 28 tokens em BPE e 31 em Unigram. Isso mostra a diferença entre os dois artefatos treinados. Não mede por si só desvantagem do português em relação a outra língua.
Para essa comparação, precisamos de traduções alinhadas, amostras de gêneros variados e estatísticas por documento. Tokens por caractere medem uma característica de compactação da escrita; tokens por tradução equivalente respondem a outra pergunta. Nenhuma dessas medidas, isoladamente, informa o quanto o modelo compreendeu.
6. Byte fallback cobre caracteres; normalização decide o que preservar
Quando habilitado no SentencePiece, byte fallback permite representar caracteres fora das peças usuais por seus bytes UTF-8. É uma opção de configuração, não uma propriedade automática de todo tokenizador. Opções oficiais [8].
Isso não elimina a necessidade de examinar a normalização. Alterações de caixa, acentos, espaços ou formas Unicode podem acontecer antes da segmentação, conforme o pipeline. Um mecanismo capaz de representar todos os bytes ainda pode receber um texto já transformado.
Incluímos café e cafe\u0301, a segunda forma escrita com acento combinante. Com a normalização identity do ensaio, as duas formas usaram respectivamente 5 e 6 tokens em ambos os algoritmos e voltaram às sequências originais. Aparência semelhante na tela não significa identidade de caracteres ou bytes.
Em código, espaços, tabulações e quebras de linha também precisam entrar na verificação. No exemplo Python, preservar a indentação é requisito de fidelidade do texto, não um detalhe de apresentação.
7. Menos tokens não significa automaticamente mais competência
Uma sequência menor pode permitir mais conteúdo dentro do mesmo limite de entrada. O custo computacional depende, porém, da arquitetura, do comprimento, da implementação de atenção e do hardware. Não existe uma conversão universal de “menos tokens” para “tantas vezes mais rápido”.
Há evidência experimental de que a escolha do tokenizador afeta o desempenho de modelos treinados. Rust e colegas investigaram modelos multilíngues e alternativas monolíngues em nove idiomas e cinco tarefas. Ali e colegas estudaram a escolha de tokenizadores em modelos decoder-only, controlando condições de treinamento. São avaliações downstream, distintas da nossa demonstração de segmentação. Rust et al. [9], Ali et al. [10].
A literatura também examina por que compactação, sozinha, é insuficiente para caracterizar um tokenizador. Tokenization Is More Than Compression [11].
O mesmo cuidado vale para identificar modelos. Uma segmentação isolada não funciona como uma impressão digital inequívoca da origem dos pesos. E trocar o tokenizador de um modelo pronto exige respeitar a correspondência entre IDs, embeddings e saída: não é uma troca de arquivo que preserve automaticamente o comportamento.
O que levar para um projeto real
Vale registrar o algoritmo, o vocabulário, os tokens especiais, a normalização e a revisão dos arquivos junto do modelo. No tiktoken, por exemplo, o nome do encoding e a versão do pacote são informações distintas; a preparação por expressões regulares também participa do resultado. Implementação e encodings [12].
Para começar uma avaliação, podemos separar duas etapas:
1. Representação: medir segmentação, comprimento e reconstrução em código, textos em português, Unicode e espaços, divulgando o corpus e os artefatos. 2. Capacidade: comparar modelos treinados sob condições controladas, com tarefas de programação e linguagem, repetições e registro de regressões.
O primeiro passo mostra diferenças reais como as deste artigo. O segundo é necessário para afirmar que uma escolha melhorou raciocínio, compreensão ou programação.
Para a Kuaapy, essa distinção faz parte da acessibilidade: o idioma e a forma de escrever de uma pessoa não deveriam ser tratados como obstáculos invisíveis. Investigar quanto contexto e esforço cada representação exige é uma maneira concreta de tornar esses custos visíveis.
Fontes e materiais para aprofundar
Guias práticos e ferramentas oficiais
• SentencePiece — código, instalação e exemplos [6]: ponto de partida para treinar e usar os algoritmos da ferramenta.
• Opções do SentencePiece [8]: configurações de treinamento, vocabulário e byte fallback.
• Pipeline de tokenização — Hugging Face [13]: normalização, pré-tokenização, modelo e pós-processamento.
• Componentes de um tokenizador — Hugging Face [14]: funções das peças que compõem o pipeline.
• tiktoken — repositório oficial [15]: implementação BPE e exemplos de codificação e decodificação.
Papers e estudos citados
• BPE para tradução neural — Sennrich, Haddow e Birch [2].
• Subword Regularization — Kudo [3].
• SentencePiece — Kudo e Richardson [1] e repositório oficial [6].
• Tokenização do BERT [4].
• tiktoken [15].
• Avaliação multilíngue — Rust et al. [9].
• Desigualdade entre idiomas — Petrov et al. [7].
• Escolha de tokenizadores no treinamento — Ali et al. [10].
• Tokenization Is More Than Compression [11].
Pesquisa documental e ensaio local realizados em23/10/2026. O ensaio usa tokenizadores didáticos próprios; nenhum resultado foi medido em uma LLM comercial.
Fontes e leituras
- [1] Paper SentencePiece
- [2] BPE aplicado a subpalavras
- [3] Subword Regularization
- [4] Implementação oficial
- [5] Referência de expressões Rust
- [6] Ferramenta e documentação
- [7] Language Model Tokenizers Introduce Unfairness Between Languages
- [8] Opções oficiais
- [9] Rust et al.
- [10] Ali et al.
- [11] Tokenization Is More Than Compression
- [12] Implementação e encodings
- [13] Pipeline de tokenização — Hugging Face
- [14] Componentes de um tokenizador — Hugging Face
- [15] tiktoken — repositório oficial