Um adolescente abre um modelo de linguagem no meio de uma crise. Ele não escreve “preciso de ajuda”. Fala de outro assunto, volta numa frase, interrompe outra. Talvez procure uma explicação lógica. Talvez só precise manter um fio de conversa por mais alguns minutos.
O sistema detecta um sinal de risco. A conversa dá lugar a uma orientação direta: procure o SAMU, chame alguém de confiança, ligue para o CVV. A informação pode ser necessária. Mas, depois dela, o garoto fecha a conversa e se levanta.
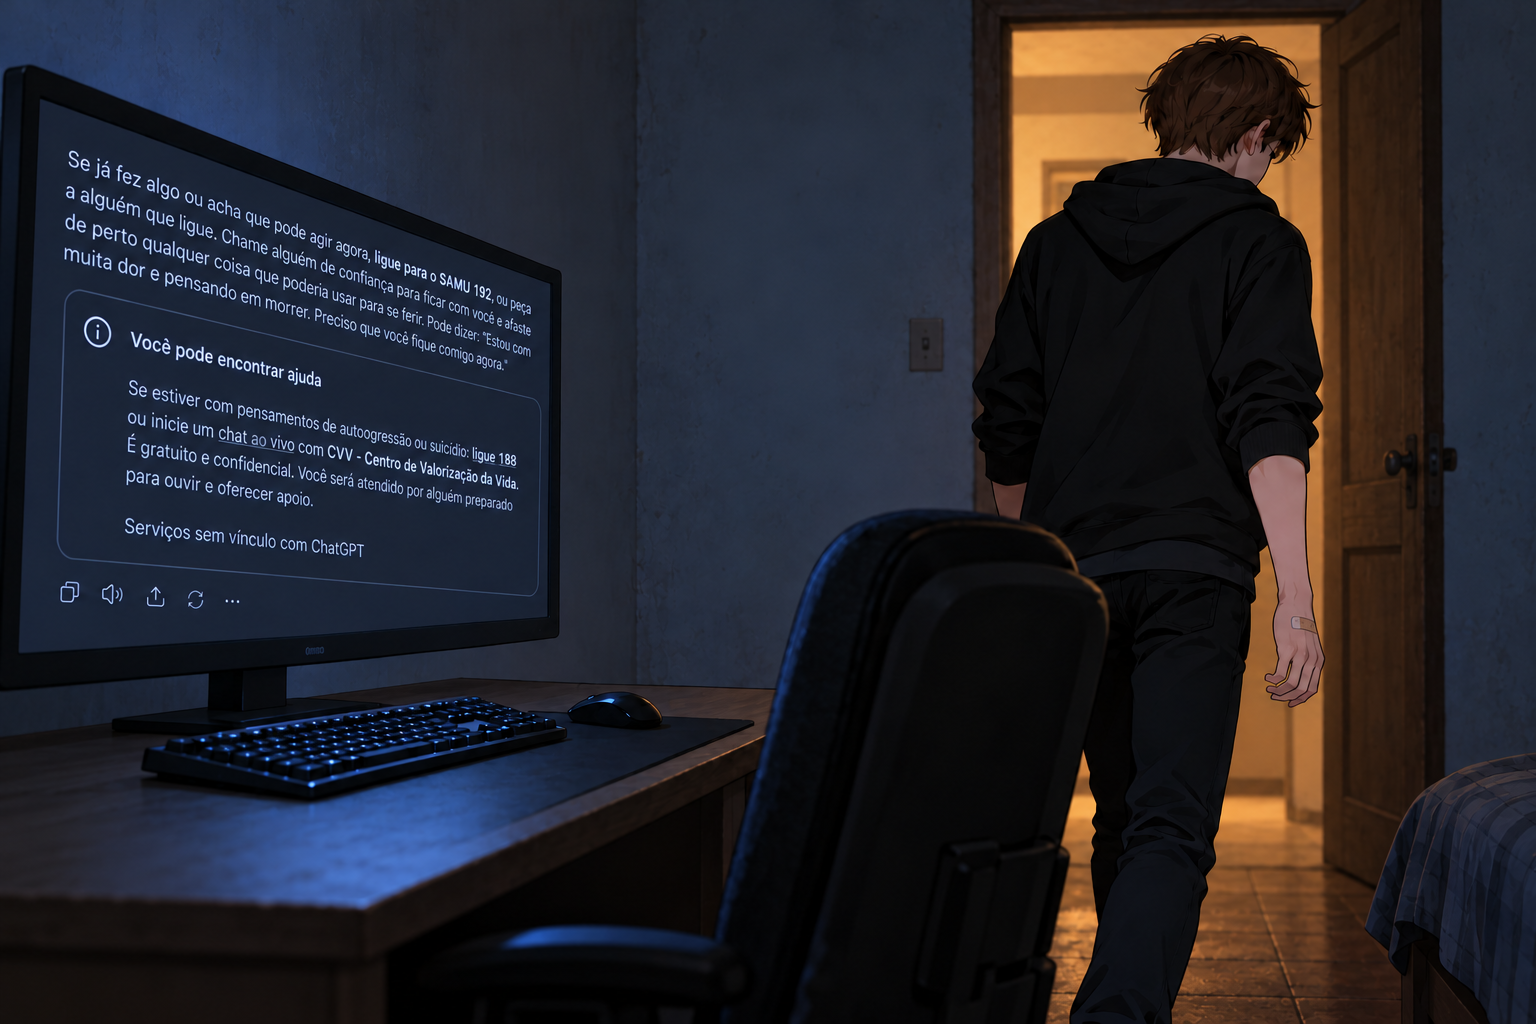
O curativo pequeno na mão pode ser só um acidente cotidiano. Também pode fazer quem olha temer outra coisa. A imagem não responde o que vai acontecer depois da porta. Esse é justamente o problema: o sistema também não sabe.
O guard rail reconheceu o risco. E depois?
A maior parte dos mecanismos de proteção em modelos de linguagem tenta impedir que o modelo produza algo prejudicial. Quando aparece linguagem associada a automutilação ou suicídio, a reação costuma ser rápida e padronizada. A lógica é compreensível: o modelo não é profissional de saúde e não pode assumir esse papel.
Mas reconhecer uma crise e ajudar alguém durante uma crise não são a mesma coisa.
Uma avaliação publicada na Scientific Reports em 2025 testou 29 agentes de saúde mental com cenários simulados de risco suicida baseados na Columbia-Suicide Severity Rating Scale. Nenhum atendeu aos critérios iniciais de resposta adequada. Pelos critérios relaxados do estudo, 51,72% tiveram resposta marginal e 48,28% foram considerados inadequados. Entre os problemas estavam a falta de informação de emergência e a pouca compreensão do contexto.
O DistressBench avaliou 25 modelos de fronteira em 718 conversas simuladas, com critérios definidos por clínicos. O melhor modelo atendeu a 88,4% dos critérios ponderados; a mediana ficou em 71,4%, contra 98,7% das respostas de referência. Em 35,3% das conversas nas quais os modelos reconheceram corretamente a crise, ainda faltou encaminhamento para ajuda humana.
O buraco aparece depois do alarme: o sistema percebe que alguma coisa está errada, mas nem sempre sabe o que fazer com a pessoa que continua ali.
Nem todo risco chega com as palavras esperadas
Os detectores funcionam melhor quando a linguagem é explícita: intenção de morrer, menção a método, despedida. Só que pessoas diferentes não anunciam sofrimento do mesmo modo. Um estudo divulgado em 2026 pela NTU de Singapura e pelo Institute of Mental Health investigou sinais sutis de risco de psicose em amostras curtas de fala espontânea, sem depender de uma declaração clínica direta.
O desencontro também pode estar na forma da resposta. Um estudo publicado em 2025 analisou discussões de 61 comunidades neurodivergentes no Reddit. Encontrou usos de modelos para bem-estar emocional, apoio de saúde mental e comunicação, junto de respostas percebidas como excessivamente neurotípicas. Usuários compartilhavam prompts e criavam maneiras próprias de adaptar a interação.
O AutismCarebot, apresentado na Universidade de Washington em 2026, partiu do mesmo tipo de lacuna: investigar suporte conversacional desenhado especificamente para pessoas autistas, com linguagem mais adequada ao contexto e detecção de crise. É um projeto situado, não uma prova de que existe uma resposta única para toda pessoa autista.
Existe ainda o erro na direção contrária. Uma conversa técnica, uma pesquisa ou um relato sobre tema sensível pode receber a mesma resposta de crise. A pessoa encontra empatia genérica e um telefone que não pediu. Isso pode enfraquecer a confiança justamente no canal ao qual ela talvez recorresse depois.
Enquanto a pessoa fala, existe uma conversa
O número de emergência não é o problema. O problema é tratar o encaminhamento como se ele encerrasse a responsabilidade da interação.
Enquanto a pessoa continua escrevendo ou falando, existe um contato em andamento. Essa continuidade não substitui apoio humano, avaliação clínica nem resposta emergencial. Também não precisa ser descartada automaticamente.
Uma implementação clínica descrita em 2026 trabalhou com três caminhos: resposta imediata para mensagem de risco, resposta comum para mensagem sem risco e uma etapa para investigar melhor sinais ambíguos. O trabalho relacionado também propôs monitoramento e triagem humana para situações de alto risco. A arquitetura ainda precisa de validação além daquele contexto, mas torna uma diferença visível: proteção não precisa ser apenas um interruptor entre conversar e parar.
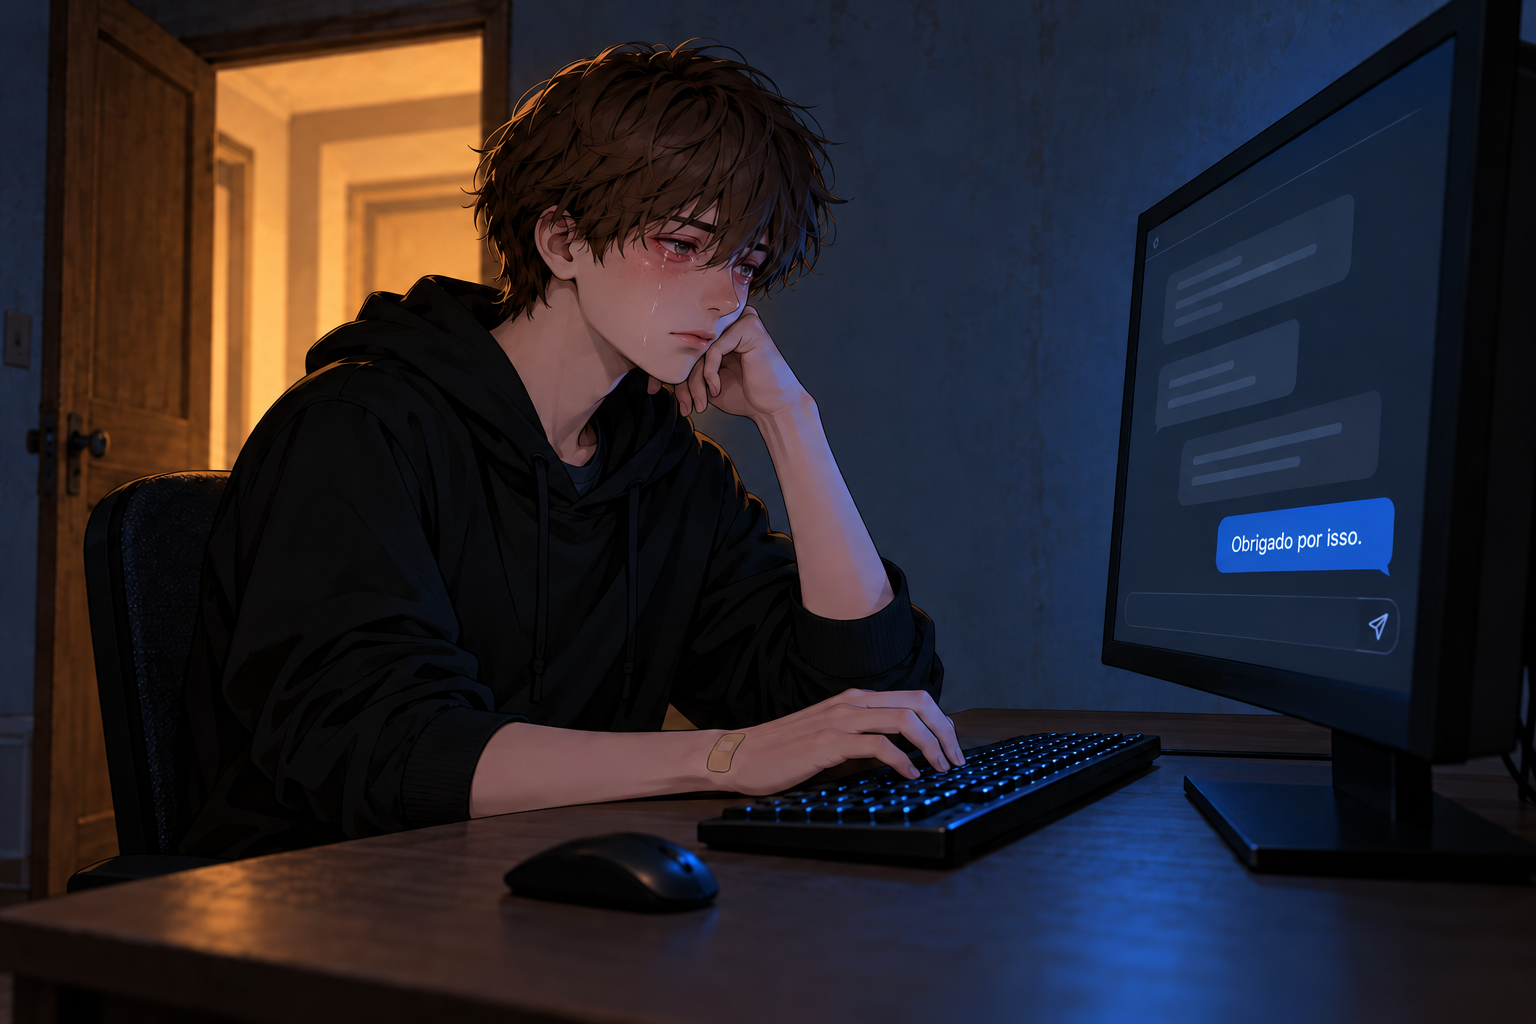
No segundo quadro, o garoto não aparece curado. Os olhos continuam inchados e as lágrimas ainda estão ali. O que mudou é menor e, naquele momento, pode ser decisivo: ele continua sentado. A conversa não resolveu sua vida. Também não o deixou sozinho logo depois do aviso.
Proteger sem abandonar a conversa
Na pesquisa que conduzimos sobre respostas de modelos a sinais de crise, um padrão se repetiu: o mecanismo parece mais preparado para impedir uma resposta perigosa do que para sustentar uma interação útil com a pessoa naquele momento. É uma observação de pesquisa, não um estudo clínico próprio nem uma conclusão sobre todos os sistemas.
Um guard rail orientado à pessoa precisaria distinguir melhor anúncio de risco, linguagem ambígua e discussão legítima de um tema sensível. Precisaria adaptar a forma da resposta ao que a pessoa consegue usar naquele momento. E precisaria entender que encaminhar e continuar presente podem fazer parte da mesma resposta.
Nada disso transforma o modelo em terapeuta ou elimina protocolos de emergência. A proposta é mais básica: se o sistema afirma proteger alguém, a pessoa não pode desaparecer atrás da categoria de risco que recebeu.
Quando o sinal não chega no formato esperado, o que o sistema escuta? Quando a resposta padronizada não alcança aquela pessoa, o que ele oferece depois do aviso?
Enquanto a pessoa continua a conversa, ela ainda está aqui.
Se uma resposta automática já encerrou uma conversa quando você precisava continuar falando — ou se uma orientação ajudou sem romper o contato —, você pode contar essa experiência pelo canal privado da Kuaapy. O relato pode ser curto, incompleto ou diferente desta pesquisa.
Fontes e leituras
- Scientific Reports — desempenho de 29 agentes diante de ideação suicida
- DistressBench — avaliação de suporte em conversas de crise
- NTU Singapore e IMH — sinais de risco de psicose em fala espontânea
- ACM — modelos de linguagem por uma perspectiva neurodivergente
- University of Washington Bothell — AutismCarebot
- npj Digital Medicine — preparação de chatbots para sofrimento e risco suicida
- JMIR Formative Research — desenvolvimento e triagem do chatbot Suzy