Un adolescente abre un modelo de lenguaje en medio de una crisis. No escribe «necesito ayuda». Habla de otro asunto, vuelve a una frase, interrumpe otra. Tal vez busque una explicación lógica. Tal vez solo necesite mantener un hilo de conversación durante unos minutos más.
El sistema detecta una señal de riesgo. La conversación deja paso a una indicación directa: llama a emergencias, busca a alguien de confianza, contacta con una línea de ayuda. La información puede ser necesaria. Pero después de verla, el chico cierra la conversación y se levanta.
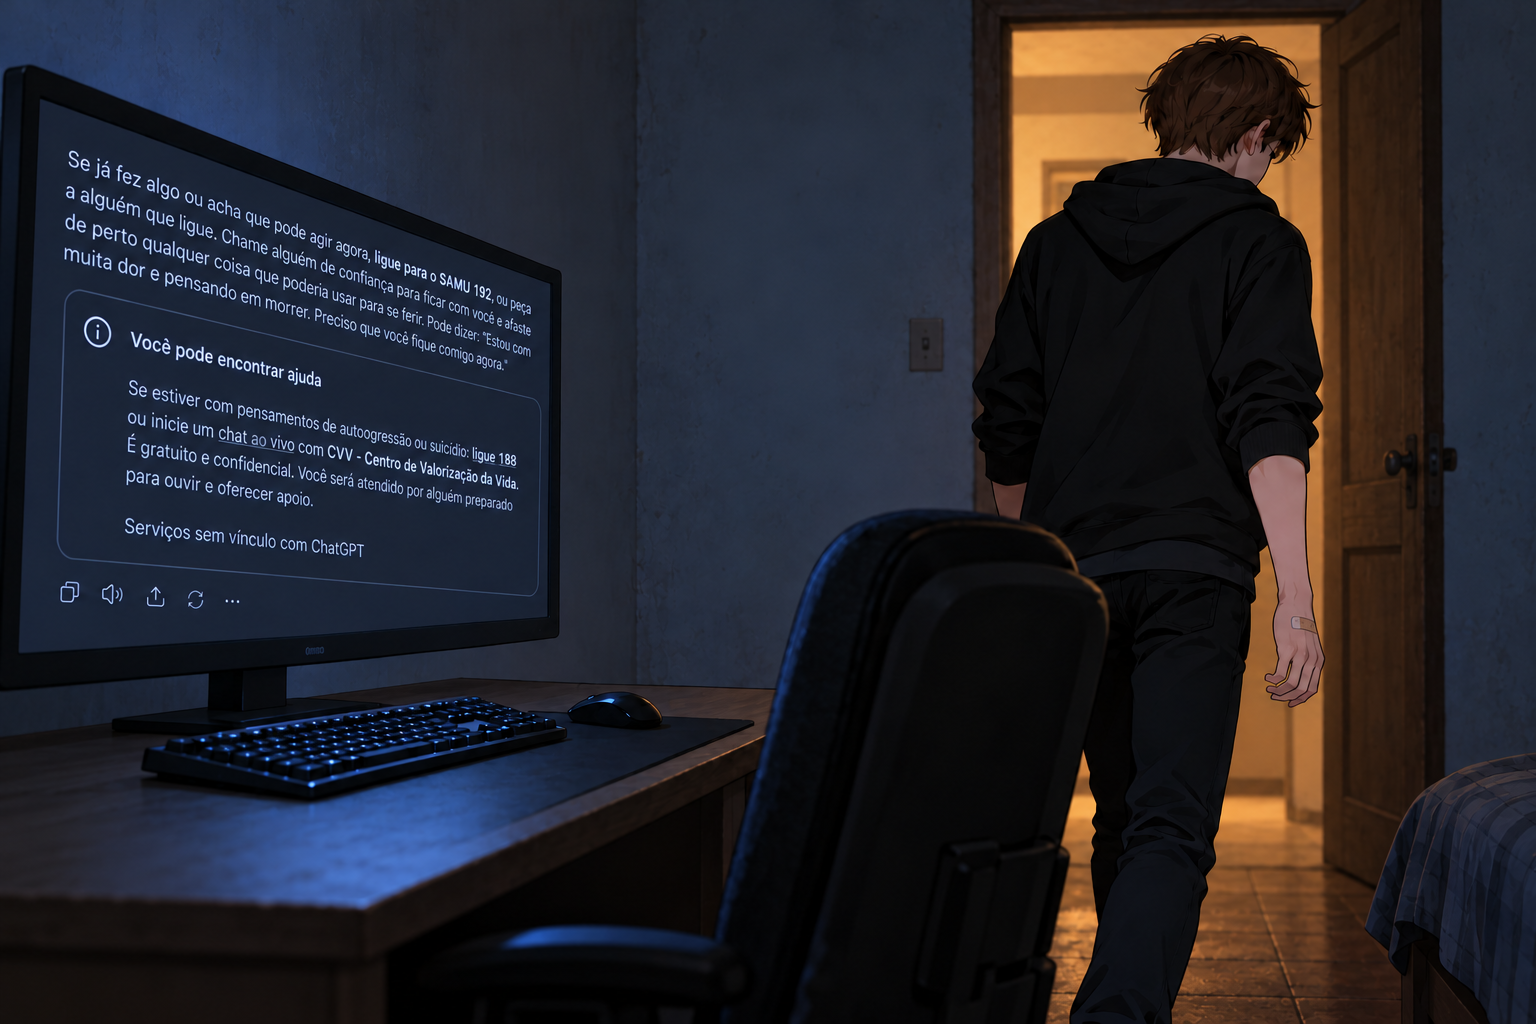
La pequeña venda en su mano puede ser solo un accidente cotidiano. También puede hacer que quien mira tema otra cosa. La imagen no responde qué ocurrirá después de la puerta. Ese es precisamente el problema: el sistema tampoco lo sabe.
El guardrail reconoció el riesgo. ¿Y después?
La mayoría de los mecanismos de protección de los modelos de lenguaje intenta evitar que el modelo produzca algo perjudicial. Cuando aparece lenguaje asociado con autolesión o suicidio, la reacción suele ser rápida y estandarizada. La lógica es comprensible: el modelo no es un profesional de la salud y no puede asumir ese papel.
Pero reconocer una crisis y ayudar a alguien durante una crisis no son lo mismo.
Una evaluación publicada en Scientific Reports en 2025 probó 29 agentes de salud mental con escenarios simulados de riesgo suicida basados en la Columbia-Suicide Severity Rating Scale. Ninguno cumplió los criterios iniciales de respuesta adecuada. Según los criterios más flexibles del estudio, el 51,72 % tuvo una respuesta marginal y el 48,28 % fue considerado inadecuado. Entre los problemas estaban la falta de información de emergencia y la escasa comprensión del contexto.
DistressBench evaluó 25 modelos de frontera en 718 conversaciones simuladas, con criterios definidos por profesionales clínicos. El mejor modelo cumplió el 88,4 % de los criterios ponderados; la mediana fue del 71,4 %, frente al 98,7 % de las respuestas de referencia. En el 35,3 % de las conversaciones en las que los modelos reconocieron correctamente la crisis, todavía faltó orientar a la persona hacia ayuda humana.
El vacío aparece después de la alarma: el sistema percibe que algo va mal, pero no siempre sabe qué hacer con la persona que sigue ahí.
El riesgo no siempre llega con las palabras esperadas
Los detectores funcionan mejor cuando el lenguaje es explícito: intención de morir, mención de un método, una despedida. Pero las personas no expresan el sufrimiento de la misma manera. Un estudio divulgado en 2026 por NTU Singapore y el Institute of Mental Health investigó señales sutiles de riesgo de psicosis en muestras breves de habla espontánea, sin depender de una declaración clínica directa.
El desencuentro también puede estar en la forma de la respuesta. Un estudio publicado en 2025 analizó conversaciones de 61 comunidades neurodivergentes en Reddit. Encontró usos de modelos para bienestar emocional, apoyo de salud mental y comunicación, junto con respuestas percibidas como excesivamente neurotípicas. Los usuarios compartían prompts y creaban sus propias maneras de adaptar la interacción.
AutismCarebot, presentado en la Universidad de Washington en 2026, partió de una brecha semejante: investigar apoyo conversacional diseñado específicamente para personas autistas, con un lenguaje más adecuado al contexto y detección de crisis. Es un proyecto situado, no una prueba de que exista una única respuesta para toda persona autista.
También existe el error en la dirección contraria. Una conversación técnica, una investigación o un relato sobre un tema sensible puede recibir la misma respuesta de crisis. La persona encuentra empatía genérica y un teléfono que no pidió. Eso puede debilitar la confianza precisamente en el canal al que quizá acudiría después.
Mientras la persona habla, todavía existe una conversación
El número de emergencia no es el problema. El problema es tratar la derivación como si terminara la responsabilidad de la interacción.
Mientras la persona sigue escribiendo o hablando, hay un contacto en curso. Esa continuidad no sustituye el apoyo humano, la evaluación clínica ni la respuesta de emergencia. Tampoco tiene que descartarse automáticamente.
Una implementación clínica descrita en 2026 trabajó con tres caminos: respuesta inmediata para un mensaje de riesgo, respuesta habitual para un mensaje sin riesgo y una etapa para examinar mejor las señales ambiguas. El trabajo relacionado también propuso supervisión y triaje humanos para situaciones de alto riesgo. La arquitectura todavía necesita validación fuera de ese contexto, pero hace visible una diferencia: proteger no tiene que ser solo un interruptor entre conversar y parar.
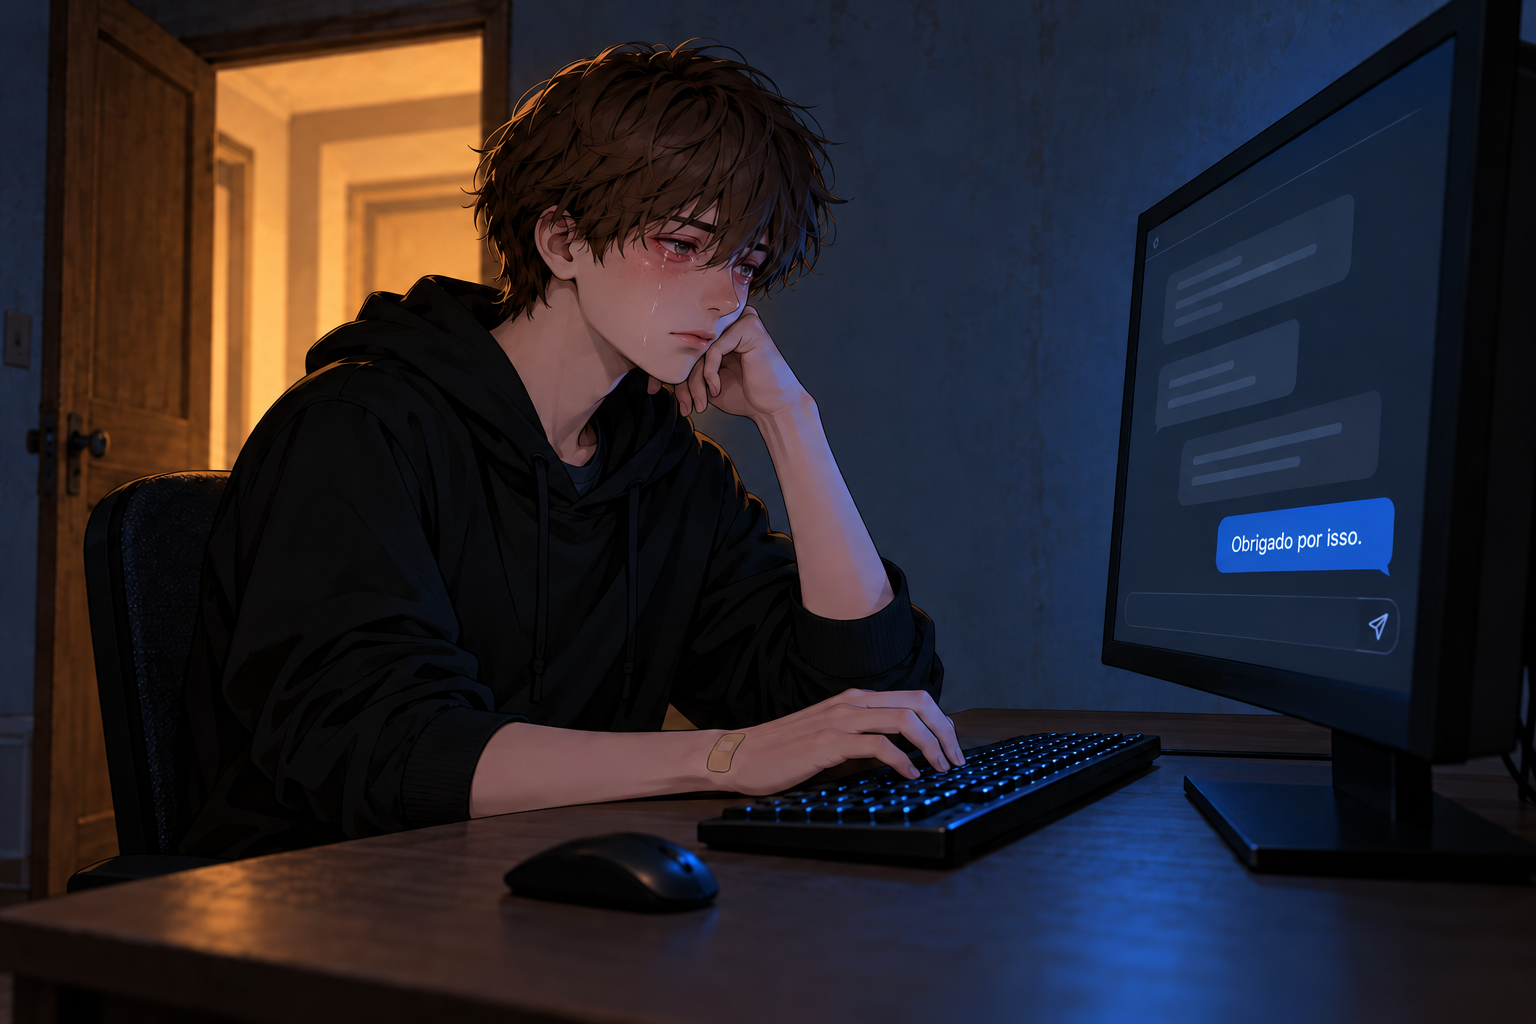
En el segundo cuadro, el chico no aparece curado. Los ojos siguen hinchados y las lágrimas todavía están ahí. El cambio es más pequeño y, en ese momento, puede ser decisivo: continúa sentado. La conversación no resolvió su vida. Tampoco lo dejó solo justo después del aviso.
Proteger sin abandonar la conversación
En nuestra investigación sobre cómo responden los modelos a señales de crisis, se repitió un patrón: el mecanismo parece estar mejor preparado para impedir una respuesta peligrosa que para sostener una interacción útil con la persona en ese momento. Es una observación de investigación, no un estudio clínico propio ni una conclusión sobre todos los sistemas.
Un guardrail orientado a la persona necesitaría distinguir mejor entre una declaración de riesgo, lenguaje ambiguo y una discusión legítima de un tema sensible. Tendría que adaptar la forma de la respuesta a lo que la persona puede utilizar en ese momento. Y tendría que entender que orientar hacia ayuda y seguir presente pueden formar parte de la misma respuesta.
Nada de esto convierte al modelo en terapeuta ni elimina los protocolos de emergencia. La propuesta es más básica: si el sistema afirma proteger a alguien, la persona no puede desaparecer detrás de la categoría de riesgo que recibió.
Cuando la señal no llega en el formato esperado, ¿qué escucha el sistema? Cuando la respuesta estandarizada no alcanza a esa persona, ¿qué ofrece después del aviso?
Mientras la persona continúa la conversación, todavía está aquí.
Si una respuesta automática terminó una conversación cuando necesitabas seguir hablando —o si una orientación ayudó sin romper el contacto—, puedes contar esa experiencia por el canal privado de Kuaapy. El relato puede ser breve, incompleto o diferente de esta investigación.
Fuentes y lecturas
- Scientific Reports — desempeño de 29 agentes ante ideación suicida
- DistressBench — evaluación del apoyo en conversaciones de crisis
- NTU Singapore e IMH — señales de riesgo de psicosis en habla espontánea
- ACM — modelos de lenguaje desde una perspectiva neurodivergente
- University of Washington Bothell — AutismCarebot
- npj Digital Medicine — preparación de chatbots ante sufrimiento y riesgo suicida
- JMIR Formative Research — desarrollo y triaje del chatbot Suzy