Pesquisa e explicação técnica. Outubro de 2026. Uma história das decisões que mudaram o cálculo, a memória e a circulação de informação nos modelos de linguagem.
Um modelo com centenas de bilhões de parâmetros pode usar apenas uma parte deles para processar um token. Outro pode percorrer um texto longo sem guardar uma chave e um valor para cada posição em todas as camadas. Um terceiro pode combinar essas duas escolhas.
Olhar apenas o número de parâmetros esconde essa diferença. A arquitetura determina onde o cálculo acontece, o que fica guardado e como uma informação pode influenciar a próxima resposta.
A história também é menos linear do que parece. MoE não nasceu depois do Transformer; mecanismos recorrentes não desapareceram quando a atenção ganhou escala. As linhas se desenvolveram em paralelo e passaram a ser combinadas. Para entender as arquiteturas atuais, precisamos acompanhar os problemas que cada uma tentou resolver.
Os anos abaixo seguem a primeira versão do preprint citado ou a publicação indicada quando não há preprint. Datas de lançamento de modelos são identificadas separadamente; não confundir ano do paper com ano de apresentação em uma conferência.
Antes da linha do tempo: três contas diferentes
Ao ler a ficha de um modelo, separe três recursos:
• Pesos: os parâmetros aprendidos que precisam ser armazenados e acessados.
• Computação por token: o trabalho executado para transformar uma representação e produzir a saída.
• Estado do contexto: o que se guarda da sequência para continuar processando ou gerando.
Reduzir uma dessas contas não reduz automaticamente as outras. MoE atua sobretudo na seleção de parâmetros das redes de transformação. Atenção esparsa seleciona posições do contexto. Mecanismos recorrentes atualizam um estado. São escolhas que podem coexistir.
Há ainda duas fases diferentes na geração autorregressiva: prefill, quando o modelo processa a entrada, e decode, quando continua a sequência. Uma solução eficiente na primeira fase pode não ter o mesmo comportamento na segunda.
1990–2014: memória recorrente e especialistas já eram linhas distintas
Redes recorrentes processam uma sequência atualizando um estado interno. O trabalho de Elman de 1990 é um marco dessa abordagem: a representação de um passo participa do processamento seguinte. Isso permite carregar informação no tempo, mas cria dependências sequenciais e dificuldades para aprender relações muito distantes. Não é a origem absoluta de toda rede recorrente. Elman, 1990 [1].
Em 1997, a LSTM introduziu uma organização de memória e portas para melhorar o aprendizado de dependências longas. A rede aprende a controlar o fluxo de informação, em vez de simplesmente substituir todo o estado a cada entrada. A memória continua finita; melhorar seu controle não equivale a preservar cada detalhe de uma sequência sem perdas. LSTM [2].
Enquanto isso, outra pergunta já estava sendo investigada: todos os exemplos precisam usar a mesma combinação de redes? O trabalho de Jacobs e colaboradores, de 1991, apresentou misturas de especialistas locais, com um mecanismo de seleção e combinação. Em 1994, Jordan e Jacobs publicaram a formulação hierárquica em árvore. Esses antecedentes não devem ser descritos como se já fossem o MoE top-k dos grandes Transformers atuais. MoE, 1991 [3], misturas hierárquicas, 1994 [4].
As perguntas eram complementares: como carregar informação ao longo da sequência e como dividir o trabalho entre partes da rede.
2014: atenção alivia o gargalo de comprimir tudo em um vetor
No modelo seq2seq de Sutskever e colaboradores, uma LSTM codifica a entrada e outra gera a saída a partir dessa representação. A abordagem tornou possível aprender transformações entre sequências de comprimentos diferentes. Mas concentrar a informação de entrada em uma representação de tamanho fixo impunha um gargalo. Seq2seq [5].
No mesmo ano, Bahdanau e colaboradores apresentaram um mecanismo de alinhamento e atenção que permite ao decodificador consultar representações de diferentes posições da entrada durante a geração. Em vez de depender apenas de um resumo único, a saída pode buscar informação em pontos diferentes da sequência. Atenção para tradução neural [6].
Os dois preprints são de setembro de 2014. A ordem de exposição aqui explica o problema e a solução; não pretende afirmar que o trabalho de atenção foi publicado depois daquele seq2seq.
2017–2019: o Transformer reorganiza o processamento
O Transformer de 2017 tornou a atenção o mecanismo central de comunicação entre posições, sem recorrência ou convolução na arquitetura apresentada. Isso favorece o processamento paralelo das posições durante o treinamento, respeitadas as máscaras. Attention Is All You Need [7].
Um bloco reúne atenção, uma rede feed-forward — FFN, aplicada às representações das posições —, conexões residuais e normalização. Atenção mistura informação entre posições; a FFN transforma cada representação usando os pesos daquele bloco.
O Transformer original é encoder-decoder. As configurações que se tornaram conhecidas depois exploram usos diferentes:
• Encoder, como BERT: usa contexto dos dois lados para construir representações, no treinamento com mascaramento descrito no paper. BERT, 2018 [8].
• Decoder-only, como o GPT inicial: usa atenção causal para prever a continuação, sem acessar tokens futuros. GPT, 2018 [9].
• Encoder-decoder, como T5: organiza tarefas como transformação de texto em texto, com um lado codificando e outro gerando. T5, 2019 [10].
“Transformer” não significa automaticamente atenção causal. A máscara e a organização do modelo determinam o que cada posição pode consultar.
O que significa ser denso
Em um Transformer denso convencional, os tokens passam pelas mesmas transformações densas do bloco, sem um roteador escolher subconjuntos de FFNs especialistas. Isso é mais preciso que dizer que literalmente cada parâmetro participa de cada token: embeddings envolvem consultas a linhas de uma tabela, por exemplo.
Também existem dois sentidos diferentes de “denso”: um modelo pode ter FFNs densas e atenção esparsa, ou ter FFNs MoE e atenção completa. O termo precisa vir acompanhado do componente ao qual se refere.
Melhorias como RMSNorm, SwiGLU e RoPE também mudaram os blocos. A LLaMA de 2023 reúne essas escolhas em um Transformer decoder. Elas afetam treinamento e processamento, mas não transformam, por si sós, uma FFN densa em MoE. LLaMA [11].
2017–2023: MoE esparso ganha escala
Ainda em janeiro de 2017, antes do preprint do Transformer, Shazeer e colaboradores apresentaram uma camada MoE com combinação esparsa de especialistas e milhares de sub-redes possíveis. O estudo inclui um modelo de até 137 bilhões de parâmetros entre camadas LSTM. A história não começa com apenas dois ou quatro especialistas. Sparsely-Gated MoE [12].
Nos Transformers MoE, é comum substituir determinadas FFNs por conjuntos de FFNs especialistas. Um roteador calcula pontuações a partir da representação do token, escolhe algumas redes e combina suas saídas. Atenção, normalização e outras partes do bloco continuam participando do processamento.
GShard, em 2020, explorou a escala distribuída dessa combinação. Switch Transformers, em 2021, estudou uma rota simplificada: selecionar um especialista por token, junto de decisões necessárias para treinar de forma estável. São escolhas de arquitetura e sistema, não apenas aumento do número escrito na ficha. GShard [13], Switch Transformers [14].
O Mixtral 8×7B, anunciado em dezembro de 2023 e descrito em paper de janeiro de 2024, tornou outro desenho bastante visível: oito especialistas por camada MoE, com dois selecionados por token. O paper informa 46,7 bilhões de parâmetros totais e 12,9 bilhões ativos por token. “8×7B” não significa oito modelos completos independentes de 7B executando ao mesmo tempo. Anúncio [15], paper do Mixtral [16].
O especialista é uma sub-rede aprendida, não necessariamente um departamento humano estável. O roteamento pode refletir padrões linguísticos, sintáticos ou de tarefas sem produzir uma divisão legível como “este é o jurídico, aquele é a programação”.
2019–2023: atenção, contexto longo e memória seguem outra trajetória
Mesmo com poucas FFNs ativas, o modelo precisa lidar com o contexto. Na atenção completa, a quantidade de relações entre posições cresce de forma quadrática com o comprimento da sequência durante o processamento conjunto, mantendo as demais dimensões fixas.
No decode com cache KV, não se recalculam todos os pares antigos a cada token: o novo token consulta chaves e valores anteriores. A consulta cresce com o histórico; o cache também ocupa mais memória à medida que a sequência aumenta. É um custo diferente do armazenamento dos pesos. MQA e o custo de decodificação [17].
Compartilhar chaves e valores: MQA e GQA
A Multi-Query Attention, de 2019, compartilha chaves e valores entre cabeças de consulta. A Grouped-Query Attention, de 2023, usa grupos: várias cabeças de consulta compartilham cada conjunto KV, oferecendo um ponto intermediário entre uma única cabeça KV e uma por cabeça de consulta. MQA [17], GQA [18].
Isso reduz o volume de KV a armazenar e movimentar. Não significa que o modelo deixou de consultar as posições permitidas pela sua atenção.
Escolher posições: Longformer e BigBird
Em 2020, Longformer combinou janelas locais com atenção global definida para a tarefa. BigBird combinou padrões locais, globais e aleatórios. São maneiras de construir conexões entre posições sem calcular todos os pares. Longformer [19], BigBird [20].
Uma janela permite examinar a vizinhança; conexões globais ou distantes ajudam a informação a circular além dela. O desenho precisa preservar os caminhos de que a tarefa necessita. “Não calcular uma conexão” não demonstra que ela seria irrelevante em toda entrada.
Executar melhor a mesma atenção: FlashAttention
FlashAttention, de 2022, é outra categoria de contribuição: reorganiza o cálculo para reduzir transferências entre níveis de memória da GPU, sem precisar materializar a matriz completa de atenção da implementação ingênua. Seu algoritmo de atenção exata não transforma automaticamente a aritmética quadrática em linear. FlashAttention [21].
Mudar as conexões e melhorar o kernel que calcula essas conexões são decisões diferentes. Uma arquitetura só entrega seus ganhos práticos quando a implementação e o hardware conseguem aproveitá-la.
2020–2025: recorrência, convoluções e memória estruturada voltam ao centro
O artigo Transformers are RNNs, de 2020, mostrou uma formulação de atenção linear com interpretação recorrente. Reorganizar a operação permite atualizar um estado em vez de guardar todas as relações explicitamente. Isso envolve uma atenção diferente da softmax convencional, não uma simples aceleração exata da mesma fórmula. Linear Attention [22].
S4 e Mamba: espaço de estados, com seleção por conteúdo
S4, em 2021, explorou modelos de espaço de estados estruturados para sequências longas. A ideia é representar a dinâmica de um estado e sua transformação em saída com uma parametrização que permita processamento eficiente. S4 [23].
Mamba, apresentado em dezembro de 2023, acrescentou seletividade dependente da entrada: mecanismos que controlam como a informação entra, permanece e é lida podem mudar conforme o conteúdo. Essa seletividade exige um algoritmo de processamento apropriado; não é apenas reutilizar a convolução de um sistema linear fixo. Mamba [24].
Mamba-2, em 2024, desenvolveu a dualidade entre modelos de espaço de estados e formas de atenção estruturada, com o framework SSD. A relação matemática permite novos algoritmos; não demonstra que qualquer SSM e qualquer Transformer sejam substitutos equivalentes em toda tarefa. Mamba-2 e SSD [25].
Na execução recorrente com dimensões fixas, o estado dessas camadas não cresce com cada token do histórico. O preço é representar o passado em uma capacidade finita, em vez de manter um registro KV separado para todas as posições. Recuperar exatamente um detalhe antigo continua sendo uma questão a avaliar.
RetNet, RWKV e DeltaNet: outras formas de atualizar memória
RetNet, em 2023, apresentou um mecanismo de retenção com formas paralela, recorrente e por blocos. RWKV explorou uma organização treinável de forma paralela, mas com inferência recorrente. São linhas relacionadas à busca de eficiência em sequências, sem serem simplesmente novos nomes para Mamba. RetNet [26], RWKV [27].
A atenção linear com portas, como GLA, permite modular a atualização de um estado matricial. DeltaNet, em 2024, explora uma regra de atualização corretiva da memória; Gated DeltaNet, apresentado na ICLR 2025, combina essa escrita corretiva com esquecimento adaptativo. Isso oferece formas diferentes de controlar o que é retido e substituído. GLA [28], DeltaNet [29], Gated DeltaNet [30].
As formas recorrentes de inferência e os algoritmos paralelos de treino são duas faces dessa engenharia. Estado de tamanho fixo em relação ao histórico não significa custo zero, nem treinamento inteiro com memória constante: dimensões, ativações, blocos e estratégia de implementação continuam importando.
Convoluções também continuaram evoluindo
Hyena, de 2023, combina convoluções longas parametrizadas e portas para misturar informação sem a atenção completa convencional. É uma outra linha de operadores para sequências. Hyena [31].
O relatório LFM2, de 2025, mostra uma combinação diferente: muitas camadas de convolução curta com portas e algumas camadas GQA, orientada a restrições de execução em dispositivos. A memória da convolução local não elimina o cache das camadas de atenção que continuam no modelo. Relatório LFM2 [32].
2024: MoE de granularidade fina muda a unidade da especialização
Agora podemos voltar ao MoE com uma pergunta mais precisa: quantos especialistas, de que tamanho, são combinados para cada token?
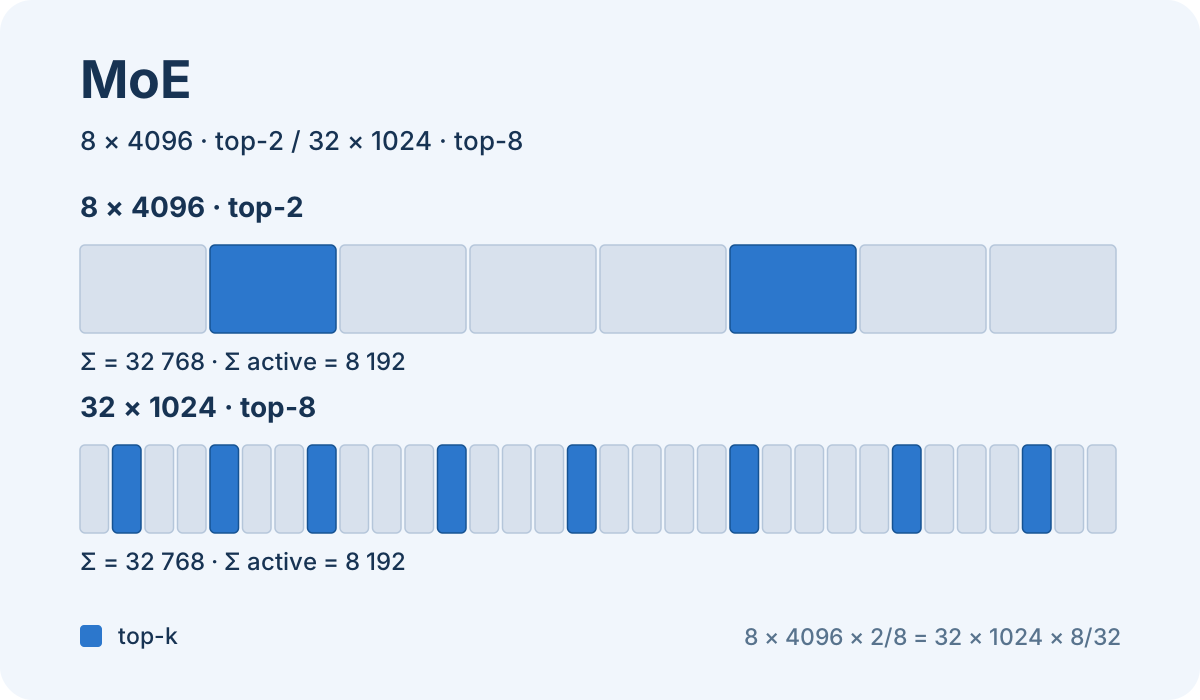
No DeepSeekMoE, de janeiro de 2024, um FFN especialista de largura intermediária h pode ser substituído, no desenho da arquitetura, por m especialistas menores de largura h/m. As dimensões de entrada e saída são mantidas. O total passa de N para mN especialistas, e a quantidade selecionada passa de K para mK. A comparação mantém o orçamento nominal dos especialistas. DeepSeekMoE, seção 3.1 [33].
São redes menores com pesos e seleção aprendidos, não apenas fatias de uma rede já treinada que conservariam automaticamente a mesma função. Trabalhos de leis de escala passaram a estudar a granularidade junto do tamanho e da quantidade de dados: o melhor ponto depende do orçamento e do regime estudado. Scaling Laws for Fine-Grained MoE [34].
Um exemplo numérico, sem apresentar cálculo como benchmark
Considere esta comparação ilustrativa entre dois desenhos de camada:
Especialistas disponíveis — Especialistas maiores: 8; Granularidade quatro vezes mais fina: 32
Especialistas selecionados por token — Especialistas maiores: 2; Granularidade quatro vezes mais fina: 8
Largura intermediária de cada especialista — Especialistas maiores: 4.096; Granularidade quatro vezes mais fina: 1.024
Soma das larguras disponíveis — Especialistas maiores: 32.768; Granularidade quatro vezes mais fina: 32.768
Soma das larguras selecionadas — Especialistas maiores: 8.192; Granularidade quatro vezes mais fina: 8.192
Conjuntos possíveis de especialistas selecionados — Especialistas maiores: 28; Granularidade quatro vezes mais fina: 10.518.300
Os números foram escolhidos para explicar a transformação, não descrevem um modelo medido aqui. O último cálculo é combinatório: escolher 2 entre 8 ou 8 entre 32, sem contar ordem nem pesos da combinação.
Para FFNs da mesma família e mesma dimensão de entrada, essas somas ajudam a comparar parâmetros e multiplicações dos especialistas, ignorando vieses e outras parcelas. Elas não contabilizam roteador, despacho, comunicação ou eficiência dos kernels.
O segundo desenho pode escolher combinações mais variadas de transformações menores. Isso cria flexibilidade potencial; não transforma milhões de combinações em milhões de habilidades demonstradas. O treinamento precisa aprender a aproveitá-las.
Especialistas compartilhados e balanceamento
Especialistas compartilhados são executados para todos os tokens nas camadas que os incluem. Os roteados são selecionados dinamicamente. A proposta busca reduzir a repetição de funções comuns entre especialistas e deixar mais espaço para diferenciação. DeepSeek-V2 combina essa organização de FFNs com MLA na atenção. DeepSeek-V2 [35].
Na comparação de orçamento do DeepSeekMoE, reservar especialistas compartilhados exige descontá-los da quantidade roteada ativa. Caso contrário, acrescenta-se computação em vez de apenas reorganizá-la. DeepSeekMoE, seção 3.2 [33].
O roteador também precisa lidar com carga. Se muitos tokens chegam ao mesmo dispositivo, esse destino pode virar o gargalo. Desequilíbrio de trabalho e colapso de especialização são problemas relacionados, mas não idênticos.
DeepSeek-V3, no fim de 2024, usa ajustes de viés para balancear o roteamento sem depender de uma perda auxiliar principal de balanceamento; o relatório ainda inclui uma pequena perda auxiliar por sequência. Também limita os nós aos quais um token é enviado. “Auxiliary-loss-free” não significa ausência de toda perda auxiliar no treinamento. DeepSeek-V3 [36].
Há outras escolhas. Em Expert Choice, de 2022, cada especialista seleciona um conjunto de tokens, permitindo que um token receba quantidades diferentes de especialistas. Isso difere do top-k por token e de uma árvore hierárquica. Restringir destinos por dispositivo ou nó, por sua vez, não prova a existência de uma árvore de especializações semânticas. Expert Choice Routing [37].
Parâmetros ativos não são memória total
Ativar menos especialistas pode reduzir o cálculo das FFNs por token. Os pesos dos outros especialistas continuam existindo: precisam residir em algum lugar e estar disponíveis quando selecionados.
Distribuí-los entre dispositivos introduz despacho e comunicação, frequentemente com trocas entre muitos destinos. Mantê-los fora da memória rápida pode introduzir transferências e latência. O ganho final depende do lote, da interconexão, da distribuição dos tokens e do runtime. A própria engenharia de comunicação ocupa uma parte importante dos trabalhos de escala. GShard [13].
Um MoE com 37B parâmetros ativos não pode ser tratado automaticamente como um denso de 37B em requisitos de memória ou velocidade.
2024–2026: as linhas passam a coexistir no mesmo modelo
Jamba, apresentado em 2024, combina camadas Mamba e Transformer, com MoE em parte das transformações. É uma demonstração clara de que “recorrente”, “atenção” e “especialistas” não são categorias mutuamente exclusivas. As camadas de atenção ainda têm seu cache; as recorrentes têm estado próprio. Jamba [38].
Comprimir KV e selecionar contexto: MLA, NSA e DSA
A MLA de DeepSeek-V2, em 2024, comprime a representação KV por posição em um espaço latente, com tratamento próprio da informação posicional. Reduz a quantidade guardada por token; isso não torna automaticamente constante o número de posições mantidas. DeepSeek-V2 [35].
Em 2025, Native Sparse Attention investigou a combinação de compressão, seleção e acesso local com um desenho alinhado ao hardware. DeepSeek Sparse Attention, descrita no relatório V3.2, usa um indexador para selecionar posições que chegam à atenção principal. Selecionar menos posições não elimina o custo de selecioná-las: é necessário examinar o sistema inteiro antes de prometer complexidade linear ou velocidade. NSA [39], DeepSeek-V3.2 [40].
Três exemplos atuais, com configurações públicas
Qwen3.5-35B-A3B-Base, 2026. O model card descreve 40 camadas organizadas em grupos de três Gated DeltaNet para uma Gated Attention, com MoE em ambos os tipos. Informa 35B parâmetros totais, aproximadamente 3B ativos e, nas camadas MoE, oito especialistas roteados ativos e um compartilhado. É uma combinação concreta de memória recorrente, atenção e seleção de FFNs. Model card [41], configuração oficial [42].
MiMo-V2-Flash, relatório de janeiro de 2026. Combina MoE com 309B parâmetros totais e 15B ativos com atenção de janela deslizante e atenção global. O relatório descreve uma proporção de cinco camadas locais para uma global. Isso reduz o alcance local por camada sem transformar todas as camadas em atenção local. As proporções de uma versão não devem ser copiadas automaticamente para toda a família MiMo. Relatório [43].
DeepSeek-V4, lançado em abril de 2026. A ficha do fornecedor mantém DeepSeekMoE e descreve atenção híbrida com CSA e HCA. CSA comprime a sequência e aplica seleção esparsa; HCA usa compressão mais forte com atenção densa sobre a representação comprimida. A ficha informa 1,6 trilhão de parâmetros totais e 49B ativos para a variante Pro. Ficha técnica oficial [44].
O V4 também introduz mHC, que reorganiza a comunicação entre fluxos residuais com restrições sobre sua mistura. Isso atua em outro eixo da arquitetura: a circulação de representações entre blocos, além da seleção de especialistas e do acesso ao contexto. A documentação da implementação explicita esses componentes. DeepSeek-V4 no Transformers [45].
Os caminhos de atenção desses modelos continuam guardando informação KV. No Qwen citado, o estado das camadas recorrentes e o KV das camadas de atenção têm comportamentos diferentes. No MiMo, a janela limita os blocos locais, enquanto os globais têm outro alcance. No V4, compressão e seleção reduzem o volume consultado; não tornam todo armazenamento independente do histórico.
Esses exemplos são configurações documentadas, não uma classificação de qualidade. Parâmetros ativos, número de especialistas e contexto anunciado não são benchmarks intercambiáveis.
2024–2026: profundidade, unidade de processamento e geração também mudam
O mapa ainda fica incompleto se olharmos apenas para FFNs e atenção. Outras linhas alteram onde gastar computação e como produzir a saída.
Recorrência em profundidade: reutilizar transformações em várias passagens pela representação tem antecedentes como Universal Transformers, de 2018. Em 2025, um estudo de profundidade recorrente explorou aumentar o cálculo no espaço latente repetindo um bloco, em vez de depender apenas de produzir mais tokens. Reutilizar pesos reduz a necessidade de parâmetros distintos para cada passagem, mas repetir o bloco ainda custa computação. É outro eixo de pesquisa, diferente de carregar estado entre tokens. Universal Transformers [46], profundidade recorrente, 2025 [47].
Mixture-of-Depths, 2024: seleciona quais tokens participam das operações de determinadas camadas, sob um orçamento. A seleção muda a distribuição de computação pela profundidade; não equivale simplesmente a escolher especialistas dentro de uma FFN. MoD [48].
Byte Latent Transformer, 2024: agrupa bytes em patches de comprimento variável e executa parte importante do processamento nessas representações, com componentes locais para entrada e saída. Aqui muda também a unidade sobre a qual a computação mais cara é organizada. BLT [49].
Multi-Token Prediction, 2024: acrescenta objetivos e módulos para prever mais de um token futuro. É preciso separar o treino da utilização desses módulos na geração. O trabalho de Gloeckle e colaboradores apresenta essa investigação; no DeepSeek-V3, os módulos podem ser descartados na inferência ou usados para apoiar decodificação especulativa. Portanto, dizer que MTP “não altera nada na inferência” é absoluto demais. MTP [50], uso no V3 [36].
Difusão para linguagem, como LLaDA, 2025: explora reconstrução de tokens mascarados em vez de apenas continuar da esquerda para a direita. Pode usar um backbone Transformer, mas muda objetivo e processo de geração. Refinar várias posições em etapas tem custos diferentes de gerar um token por passo; não se presume menor latência apenas pela possibilidade de paralelismo. LLaDA [51].
Memória aprendida durante o uso, como Titans, na virada de 2024 para 2025: investiga módulos de memória de longo prazo atualizados em tempo de teste. Esse tipo de memória não é um banco externo de documentos nem apenas o cache KV. É uma linha de pesquisa com regras próprias de atualização, custo e avaliação. Titans [52].
Em 2026, Mamba-3 também continua desenvolvendo a linha de espaço de estados. A existência de um novo paper amplia o mapa, mas não comprova adoção generalizada ou superioridade sobre modelos em escalas e tarefas diferentes. Mamba-3 [53].
A linha do tempo, sem transformar ramificações em substituições
1990–1997: recorrência e LSTM — O que passa a ser possível investigar ou organizar melhor: Carregar e controlar estado ao processar sequências.
1991–1994: misturas de especialistas — O que passa a ser possível investigar ou organizar melhor: Dividir e combinar funções aprendidas, inclusive hierarquicamente.
2014: seq2seq e atenção — O que passa a ser possível investigar ou organizar melhor: Transformar sequências e consultar posições da entrada durante a geração.
2017: sparse-gated MoE e Transformer — O que passa a ser possível investigar ou organizar melhor: Escalar seleção de sub-redes e reorganizar comunicação entre posições.
2018–2019: GPT, BERT e T5 — O que passa a ser possível investigar ou organizar melhor: Explorar decoders, encoders e combinações encoder-decoder.
2019–2023: MQA, atenção esparsa, FlashAttention e GQA — O que passa a ser possível investigar ou organizar melhor: Reduzir KV, escolher conexões e melhorar execução, por mecanismos distintos.
2020–2024: atenção linear, S4, Mamba e SSD — O que passa a ser possível investigar ou organizar melhor: Atualizar memória estruturada e aproximar perspectivas recorrentes e paralelas.
2024: fine-grained MoE, MLA, Jamba e DeltaNet — O que passa a ser possível investigar ou organizar melhor: Refinar especialistas, comprimir KV, combinar operadores e controlar escrita de memória.
2024–2025: MoD, BLT, MTP e difusão — O que passa a ser possível investigar ou organizar melhor: Mudar profundidade executada, unidade de processamento e geração.
2025–2026: NSA, DSA, LFM2 e híbridos públicos recentes — O que passa a ser possível investigar ou organizar melhor: Combinar essas escolhas em configurações específicas de modelos.
Os anos indicam os marcos discutidos e suas fontes, não uma reivindicação de que toda ideia começou ali. Há trabalhos anteriores, versões posteriores e outras linhagens. A cronologia explica como os mecanismos se conectam; não estabelece um vencedor.
Como ler a arquitetura de um modelo sem se perder nos nomes
Em vez de perguntar apenas se o modelo é denso ou MoE, procure respostas para cinco questões:
1. Como as posições trocam informação? Atenção completa, janelas, seleção esparsa, convolução, recorrência ou combinação? 2. Quais transformações são executadas? FFNs densas, especialistas roteados, compartilhados ou profundidade variável? 3. O que cresce com o histórico? KV por posição, representações comprimidas, estado recorrente e buffers locais precisam ser separados. 4. Como o modelo aprende e gera? Próximo token, MTP, difusão e decodificação especulativa não são a mesma decisão. 5. Que implementação sustentou os resultados? Precisão numérica, lote, contexto, kernels e hardware definem o custo observado.
Para comparar eficiência, meça prefill, latência por token, throughput, memória e qualidade nas tarefas relevantes, com condições equivalentes. Um resultado de laboratório ou um número de parâmetros ativos não demonstra sozinho uma melhora geral.
O avanço mais interessante desse percurso é a liberdade de compor: usar especialistas menores onde a combinação ajuda, memória recorrente onde o estado basta e acesso mais direto ao contexto onde ele é necessário. Cada escolha precisa justificar o que preserva, o que comprime e o que custa quando o modelo realmente começa a trabalhar.
Fontes e leituras
- [1] Elman, 1990
- [2] LSTM
- [3] MoE, 1991
- [4] misturas hierárquicas, 1994
- [5] Seq2seq
- [6] Atenção para tradução neural
- [7] Attention Is All You Need
- [8] BERT, 2018
- [9] GPT, 2018
- [10] T5, 2019
- [11] LLaMA
- [12] Sparsely-Gated MoE
- [13] GShard
- [14] Switch Transformers
- [15] Anúncio
- [16] paper do Mixtral
- [17] MQA e o custo de decodificação
- [18] GQA
- [19] Longformer
- [20] BigBird
- [21] FlashAttention
- [22] Linear Attention
- [23] S4
- [24] Mamba
- [25] Mamba-2 e SSD
- [26] RetNet
- [27] RWKV
- [28] GLA
- [29] DeltaNet
- [30] Gated DeltaNet
- [31] Hyena
- [32] Relatório LFM2
- [33] DeepSeekMoE, seção 3.1
- [34] Scaling Laws for Fine-Grained MoE
- [35] DeepSeek-V2
- [36] DeepSeek-V3
- [37] Expert Choice Routing
- [38] Jamba
- [39] NSA
- [40] DeepSeek-V3.2
- [41] Model card
- [42] configuração oficial
- [43] Relatório
- [44] Ficha técnica oficial
- [45] DeepSeek-V4 no Transformers
- [46] Universal Transformers
- [47] profundidade recorrente, 2025
- [48] MoD
- [49] BLT
- [50] MTP
- [51] LLaDA
- [52] Titans
- [53] Mamba-3