Criar uma família de modelos não precisa começar com o treinamento de uma inteligência artificial do zero. Pode começar com modelos já disponíveis, uma função bem definida e uma pergunta: o que cada integrante dessa família precisa fazer bem?
Entender esse trabalho começa por distinguir conceitos que costumam aparecer juntos: modelo base, merge, fine-tuning, adapter e aprendizado por reforço. Cada um tem um papel. Nenhum deles, sozinho, define uma família.
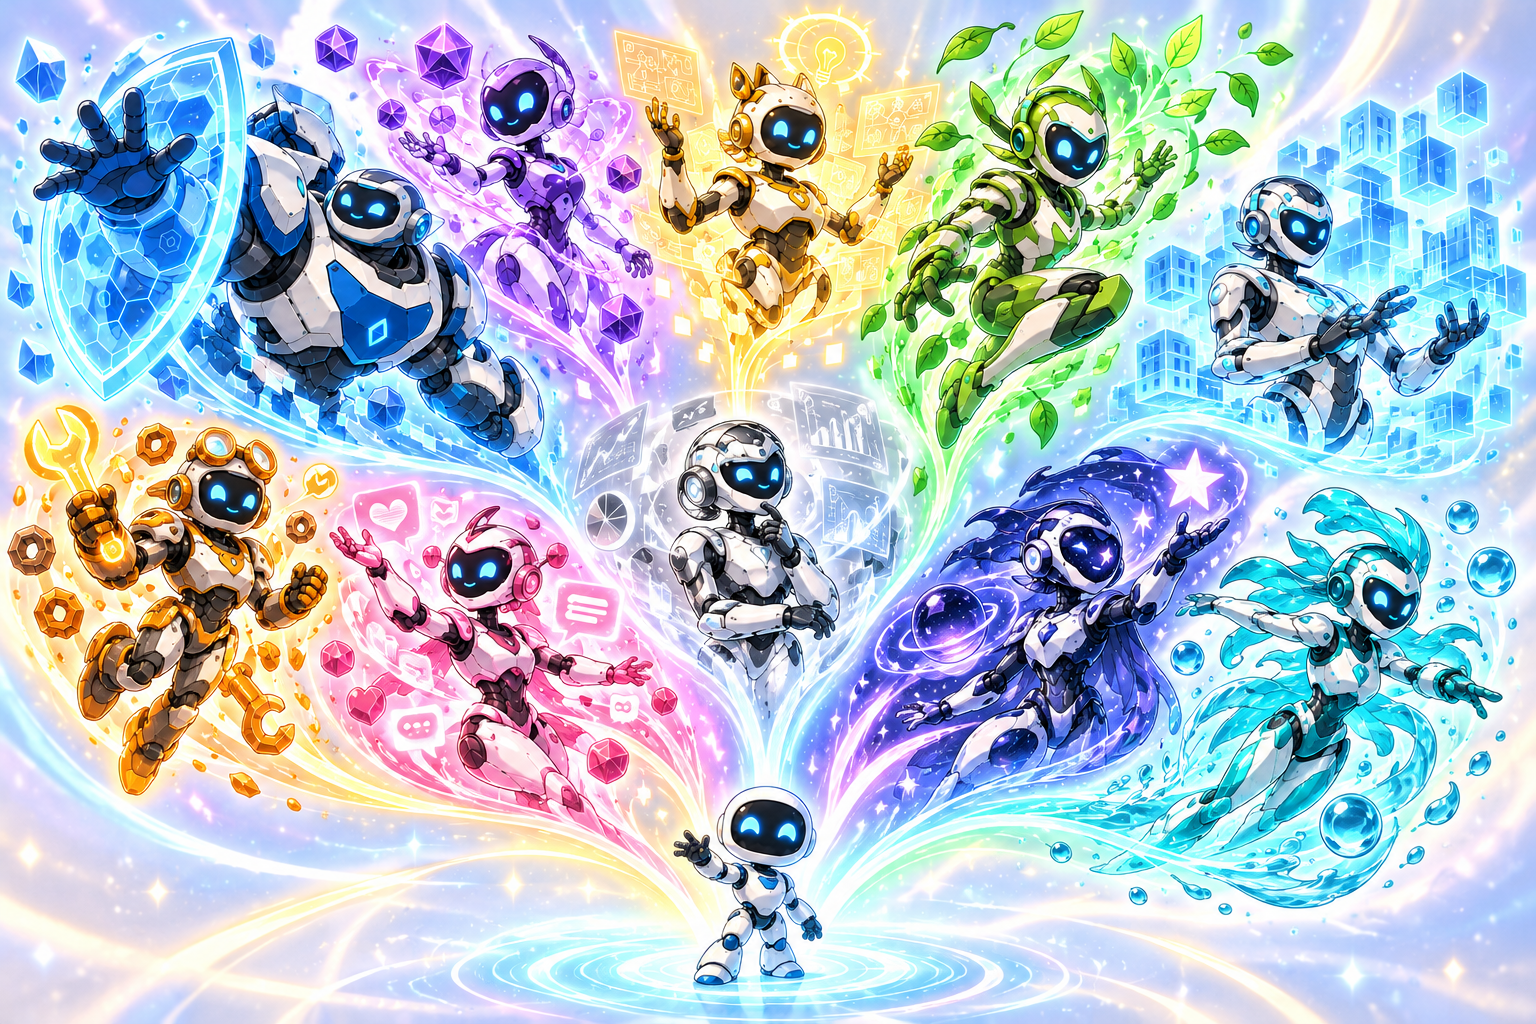
Antes das ferramentas, o tronco e as ramificações
Um modelo base é um ponto de partida já treinado. Ele carrega capacidades e limitações do seu treinamento. Não é uma página em branco, e ter alcance amplo não significa saber de tudo ou servir igualmente bem a qualquer tarefa.
Um modelo voltado a um domínio é preparado para um recorte: uma área de conhecimento, um tipo de documento ou uma necessidade de uso. Marketing e documentação técnica são exemplos de recortes possíveis; manter um estilo ou extrair campos são exemplos de funções que podem existir dentro deles.
A imagem de uma árvore ajuda: um tronco comum pode dar origem a ramificações com funções diferentes. É uma maneira de organizar uma família, não uma regra que obriga todos os projetos a terem exatamente a mesma origem. A família é o conjunto planejado; uma técnica de adaptação, sozinha, não define esse conjunto.
O papel de cada modelo
Uma família começa com funções definidas. Qual tarefa cada modelo recebe? Como deve entregar a resposta? Que erros tornam o resultado inútil? O que fica fora da sua função?
Sem essas respostas, é fácil terminar com vários arquivos de modelos e nenhuma diferença clara entre o que cada um oferece. Uma família especializada precisa de papéis que façam sentido para quem vai usá-la.
A escolha da base
A escolha de um modelo base influencia as capacidades, as limitações e as possibilidades de adaptação de cada integrante. Essa escolha faz parte do projeto da família.
Também é preciso verificar o que cada licença permite fazer com os modelos e seus derivados. A licença da ferramenta usada para trabalhar nos pesos não substitui a licença dos próprios modelos.
Uma base de domínio pode sustentar várias especializações
Entre uma base de alcance geral e um modelo preparado para uma tarefa específica, pode existir uma base de domínio. Ela concentra conhecimento e padrões de uma área, mas permanece como ponto de partida para diferentes aplicações dentro desse recorte.
Nesse sentido, ela é mais neutra em relação à aplicação final: ainda não está comprometida com uma única função, um formato de resposta ou um estilo de atendimento. Essa neutralidade é relativa ao uso que vem depois; não significa ausência de vieses ou limitações.
Uma mesma base de domínio pode sustentar um modelo voltado à documentação, outro à extração de informações e outro à interação com o usuário. Eles compartilham uma fundação, mas cada um precisa de preparação e avaliação próprias para a função que vai assumir.
Escolher uma base existente e desenvolver uma base de domínio são decisões distintas. A segunda pode se apoiar em um modelo já treinado e continuar sua preparação para aquela área. Criar essa fundação comum faz parte do projeto de uma família; não exige, por definição, começar com pesos aleatórios.
Combinar pode ser uma etapa
O MergeKit é uma ferramenta para combinar pesos de modelos treinados. Isso é diferente de reunir respostas de vários modelos durante uma conversa: a operação produz um novo artefato a partir dos pesos escolhidos.
Existem métodos diferentes para essa combinação. Eles fazem escolhas sobre como misturar as contribuições dos modelos e lidar com diferenças entre elas. A escolha depende dos modelos envolvidos e do resultado que se quer investigar; compatibilidade precisa ser verificada.
Combinar um modelo com boa escrita e outro com bom raciocínio não garante um resultado que reúna o melhor dos dois. O merge cria um candidato. A avaliação é que vai dizer se ele preservou capacidades, ganhou algo útil ou piorou no que importava.
O projeto oferece caminhos de execução em CPU e aceleração por GPU. Isso não transforma uma quantidade específica de memória em garantia para qualquer combinação: os requisitos dependem dos modelos e da configuração.
O objetivo do treinamento e a forma de ajustar são coisas diferentes
Uma forma simples de organizar os termos é fazer duas perguntas: o que queremos que o modelo aprenda e quais parâmetros vamos ajustar para isso?
No pré-treinamento, o modelo aprende padrões a partir de grandes conjuntos de dados. Esse aprendizado também pode continuar a partir de um modelo existente, com material escolhido para um domínio. No ajuste supervisionado, ou SFT, exemplos orientam o comportamento desejado: o modelo recebe situações e respostas usadas como referência de treinamento.
Outro objetivo é aprender preferências entre respostas possíveis. Isso pode envolver avaliações humanas, sinais automáticos ou combinações, conforme o método. Nem todo treinamento por preferência é aprendizado por reforço: existem abordagens que usam essas comparações diretamente.
Onde entra o aprendizado por reforço
No aprendizado por reforço, o treinamento usa um sinal de recompensa para orientar o comportamento do modelo. A recompensa representa um critério escolhido para a tarefa; não é uma prova automática de que a resposta ficou correta.
RLHF significa aprendizado por reforço com feedback humano. Em uma abordagem comum, pessoas avaliam respostas e essas avaliações ajudam a construir um modelo de recompensa, usado para orientar o ajuste do modelo que responde. É uma maneira de transformar preferências em um sinal de treinamento.
Isso não significa que alguém precisa aprovar manualmente cada resposta depois que o sistema entra em uso. Também não garante alinhamento perfeito: o sinal pode representar mal o que se queria e favorecer comportamentos que parecem bons na avaliação, mas falham em situações reais.
Fine-tuning pode usar adapters — e adapter não é sinônimo de LoRA
Fine-tuning é o ajuste de um modelo já treinado. Ele pode atualizar todos os parâmetros da base ou usar estratégias que ajustam apenas uma parte deles ou parâmetros adicionais. Essa escolha é diferente do objetivo do treinamento: seguir exemplos ou aprender preferências, por exemplo.
Um adapter é um mecanismo de adaptação associado ao modelo. Em diferentes métodos, ele pode acrescentar componentes treináveis ou representar ajustes que trabalham junto da base, mantendo seus pesos originais congelados. A forma exata depende do método e da implementação.
LoRA é um tipo de adapter nesse sentido amplo: representa atualizações por meio de matrizes menores treináveis. O termo adapter não quer dizer exclusivamente LoRA. Há outras formas de adaptação, e o nome usado no projeto precisa indicar qual delas está em questão.
Um adapter também não é, sozinho, o modelo completo. Ele depende de uma base compatível. Por isso, uma coleção de adapters não deve ser confundida automaticamente com uma família de modelos completos ou com qualquer receita única de especialização.
Ajustar para o recorte é outra etapa possível
Quando o objetivo pede adaptação com dados específicos, ferramentas como o Axolotl ajudam a organizar o treinamento. A configuração descreve elementos como modelo, dados e estratégia de ajuste, permitindo registrar o processo e acompanhar seus resultados.
Isso não torna o ajuste obrigatório depois de todo merge. Também não faz de fine-tuning e família de modelos a mesma coisa. Um é uma forma de adaptar; a outra é a organização de modelos com propósitos definidos. O caminho de construção de cada integrante depende do projeto.
Escolher dados adequados continua sendo parte central do trabalho. Uma ferramenta de treinamento organiza a execução; ela não decide sozinha o que representa uma boa resposta para o domínio.
Avaliar antes de apresentar como especialista
Cada candidato precisa ser comparado com uma referência: o modelo de partida, outra alternativa apropriada ou ambos. Os exemplos da avaliação devem permitir observar o comportamento em situações que não foram simplesmente repetidas na preparação.
O que se mede depende da função. Pode ser correção dos campos extraídos, respeito ao formato, fidelidade a uma referência ou quantidade de revisão necessária. Quando houver variação, uma execução isolada não basta para representar o desempenho.
Também é importante registrar as perdas. Um modelo pode melhorar em um recorte e piorar em outro. Especialização não implica redução automática de tamanho, eliminação de erros ou superioridade garantida.
Da coleção à família
O resultado que se procura é um conjunto com funções claras, versões identificáveis e critérios para decidir quando cada modelo está pronto para uso. Se esses modelos forem oferecidos por API, quem integra precisa compreender a função de cada um e os limites da entrega.
Essa é a direção da família de modelos especializados da Kuaapy. Na nossa proposta, o trabalho de fine-tuning da fase 3 e a construção da família na fase 4 têm escopos distintos. Adaptar um modelo para uma necessidade e desenvolver uma família com funções próprias são entregas diferentes.
Para conhecer essa direção e conversar sobre uma necessidade específica, visite a área de Serviços da Kuaapy.
Fontes e leituras
Para continuar a leitura
Fontes e leituras
O ponto de partida é reaproveitar conhecimento existente. O que transforma esse reaproveitamento em uma família com propósito é definir funções, construir candidatos e conferir o que cada um realmente entrega.