Investigación y explicación técnica. Octubre de 2026. Una historia de las decisiones que cambiaron el cálculo, la memoria y la circulación de información en los modelos de lenguaje.
Un modelo con cientos de miles de millones de parámetros puede utilizar solo una parte para procesar un token. Otro puede recorrer un texto largo sin guardar una clave y un valor para cada posición en todas las capas. Un tercero puede combinar ambas decisiones.
Mirar solo el número de parámetros oculta esta diferencia. La arquitectura determina dónde ocurre el cálculo, qué queda guardado y cómo una información puede influir en la siguiente respuesta.
La historia también es menos lineal de lo que parece. MoE no nació después del Transformer; los mecanismos recurrentes no desaparecieron cuando la atención ganó escala. Las líneas se desarrollaron en paralelo y empezaron a combinarse. Para entender las arquitecturas actuales, debemos seguir los problemas que cada una intentó resolver.
Los años que aparecen abajo siguen la primera versión del preprint citado o la publicación indicada cuando no existe preprint. Las fechas de lanzamiento de modelos se identifican por separado; no hay que confundir el año del paper con el año de presentación en una conferencia.
Antes de la línea temporal: tres cuentas diferentes
Al leer la ficha de un modelo, separa tres recursos:
• Pesos: los parámetros aprendidos que deben almacenarse y consultarse.
• Cómputo por token: el trabajo ejecutado para transformar una representación y producir la salida.
• Estado del contexto: lo que se conserva de la secuencia para continuar procesando o generando.
Reducir una de estas cuentas no reduce automáticamente las otras. MoE actúa sobre todo en la selección de parámetros de las redes de transformación. La atención dispersa selecciona posiciones del contexto. Los mecanismos recurrentes actualizan un estado. Son decisiones que pueden coexistir.
También hay dos fases diferentes en la generación autorregresiva: prefill, cuando el modelo procesa la entrada, y decode, cuando continúa la secuencia. Una solución eficiente en la primera fase puede no comportarse igual en la segunda.
1990–2014: la memoria recurrente y los expertos ya eran líneas distintas
Las redes recurrentes procesan una secuencia actualizando un estado interno. El trabajo de Elman de 1990 es un hito de este enfoque: la representación de un paso participa en el procesamiento siguiente. Esto permite transportar información en el tiempo, pero crea dependencias secuenciales y dificultades para aprender relaciones muy distantes. No es el origen absoluto de toda red recurrente. Elman, 1990 [1].
En 1997, LSTM introdujo una organización de memoria y puertas para mejorar el aprendizaje de dependencias largas. La red aprende a controlar el flujo de información, en lugar de sustituir simplemente todo el estado en cada entrada. La memoria sigue siendo finita; mejorar su control no equivale a preservar sin pérdidas cada detalle de una secuencia. LSTM [2].
Mientras tanto, ya se investigaba otra pregunta: ¿todos los ejemplos necesitan utilizar la misma combinación de redes? El trabajo de Jacobs y sus colegas de 1991 presentó mezclas de expertos locales, con un mecanismo de selección y combinación. En 1994, Jordan y Jacobs publicaron la formulación jerárquica en árbol. Estos antecedentes no deben describirse como si ya fueran el MoE top-k de los grandes Transformers actuales. MoE, 1991 [3], mezclas jerárquicas, 1994 [4].
Las preguntas eran complementarias: cómo transportar información a lo largo de la secuencia y cómo dividir el trabajo entre partes de la red.
2014: la atención alivia el cuello de botella de comprimirlo todo en un vector
En el modelo seq2seq de Sutskever y sus colegas, una LSTM codifica la entrada y otra genera la salida a partir de esa representación. El enfoque hizo posible aprender transformaciones entre secuencias de longitudes diferentes. Pero concentrar la información de entrada en una representación de tamaño fijo imponía un cuello de botella. Seq2seq [5].
Ese mismo año, Bahdanau y sus colegas presentaron un mecanismo de alineación y atención que permite al decodificador consultar representaciones de distintas posiciones de la entrada durante la generación. En lugar de depender solo de un resumen único, la salida puede buscar información en puntos diferentes de la secuencia. Atención para traducción neuronal [6].
Los dos preprints son de septiembre de 2014. El orden de exposición explica aquí el problema y la solución; no pretende afirmar que el trabajo sobre atención se publicara después del trabajo seq2seq.
2017–2019: el Transformer reorganiza el procesamiento
El Transformer de 2017 convirtió la atención en el mecanismo central de comunicación entre posiciones, sin recurrencia ni convolución en la arquitectura presentada. Esto favorece el procesamiento paralelo de las posiciones durante el entrenamiento, respetando las máscaras. Attention Is All You Need [7].
Un bloque reúne atención, una red feed-forward — FFN, aplicada a las representaciones de las posiciones —, conexiones residuales y normalización. La atención mezcla información entre posiciones; la FFN transforma cada representación utilizando los pesos de ese bloque.
El Transformer original es encoder-decoder. Las configuraciones que se hicieron conocidas después exploran usos distintos:
• Encoder, como BERT: utiliza el contexto de ambos lados para construir representaciones, con el entrenamiento mediante enmascaramiento descrito en el paper. BERT, 2018 [8].
• Decoder-only, como el GPT inicial: utiliza atención causal para predecir la continuación, sin acceder a tokens futuros. GPT, 2018 [9].
• Encoder-decoder, como T5: organiza las tareas como transformación de texto en texto, con un lado que codifica y otro que genera. T5, 2019 [10].
“Transformer” no significa automáticamente atención causal. La máscara y la organización del modelo determinan qué puede consultar cada posición.
Qué significa ser denso
En un Transformer denso convencional, los tokens pasan por las mismas transformaciones densas del bloque, sin que un router elija subconjuntos de FFN expertas. Es más preciso que decir que literalmente cada parámetro participa en cada token: los embeddings, por ejemplo, consultan filas de una tabla.
También existen dos sentidos diferentes de “denso”: un modelo puede tener FFN densas y atención dispersa, o FFN MoE y atención completa. El término debe ir acompañado del componente al que se refiere.
Mejoras como RMSNorm, SwiGLU y RoPE también cambiaron los bloques. La LLaMA de 2023 reúne esas elecciones en un Transformer decoder. Afectan al entrenamiento y al procesamiento, pero no convierten por sí mismas una FFN densa en MoE. LLaMA [11].
2017–2023: el MoE disperso gana escala
En enero de 2017, antes del preprint del Transformer, Shazeer y sus colegas presentaron una capa MoE con combinación dispersa de expertos y miles de subredes posibles. El estudio incluye un modelo de hasta 137 mil millones de parámetros entre capas LSTM. La historia no comienza con solo dos o cuatro expertos. Sparsely-Gated MoE [12].
En los Transformers MoE es habitual sustituir determinadas FFN por conjuntos de FFN expertas. Un router calcula puntuaciones a partir de la representación del token, elige algunas redes y combina sus salidas. La atención, la normalización y otras partes del bloque siguen participando en el procesamiento.
GShard, en 2020, exploró la escala distribuida de esta combinación. Switch Transformers, en 2021, estudió una ruta simplificada: seleccionar un experto por token, junto con decisiones necesarias para entrenar de forma estable. Son elecciones de arquitectura y sistema, no solo un aumento del número escrito en la ficha. GShard [13], Switch Transformers [14].
Mixtral 8×7B, anunciado en diciembre de 2023 y descrito en un paper de enero de 2024, hizo visible otro diseño: ocho expertos por capa MoE, con dos seleccionados por token. El paper informa de 46,7 mil millones de parámetros totales y 12,9 mil millones activos por token. “8×7B” no significa ocho modelos completos independientes de 7B ejecutándose a la vez. Anuncio [15], paper de Mixtral [16].
Un experto es una subred aprendida, no necesariamente un departamento humano estable. El enrutamiento puede reflejar patrones lingüísticos, sintácticos o de tareas sin producir una división legible como “este es jurídico, aquel es programación”.
2019–2023: atención, contexto largo y memoria siguen otra trayectoria
Incluso con pocas FFN activas, el modelo debe manejar el contexto. En la atención completa, la cantidad de relaciones entre posiciones crece cuadráticamente con la longitud de la secuencia durante el procesamiento conjunto, manteniendo fijas las demás dimensiones.
En el decode con caché KV no se recalculan todos los pares antiguos para cada token: el token nuevo consulta claves y valores anteriores. La consulta crece con el historial; la caché también ocupa más memoria a medida que aumenta la secuencia. Es un coste distinto del almacenamiento de los pesos. MQA y coste de decodificación [17].
Compartir claves y valores: MQA y GQA
La Multi-Query Attention, de 2019, comparte claves y valores entre cabezas de consulta. La Grouped-Query Attention, de 2023, utiliza grupos: varias cabezas de consulta comparten cada conjunto KV, ofreciendo un punto intermedio entre una sola cabeza KV y una por cabeza de consulta. MQA [17], GQA [18].
Esto reduce el volumen de KV que hay que almacenar y mover. No significa que el modelo haya dejado de consultar las posiciones permitidas por su atención.
Elegir posiciones: Longformer y BigBird
En 2020, Longformer combinó ventanas locales con atención global definida para la tarea. BigBird combinó patrones locales, globales y aleatorios. Son formas de construir conexiones entre posiciones sin calcular todos los pares. Longformer [19], BigBird [20].
Una ventana permite examinar el vecindario; las conexiones globales o lejanas ayudan a que la información circule más allá. El diseño debe conservar los caminos que la tarea necesita. “No calcular una conexión” no demuestra que sea irrelevante en toda entrada.
Ejecutar mejor la misma atención: FlashAttention
FlashAttention, de 2022, es otra categoría de contribución: reorganiza el cálculo para reducir transferencias entre niveles de memoria de la GPU sin materializar la matriz completa de atención de la implementación ingenua. Su algoritmo de atención exacta no convierte automáticamente la aritmética cuadrática en lineal. FlashAttention [21].
Cambiar las conexiones y mejorar el kernel que calcula esas conexiones son decisiones diferentes. Una arquitectura solo entrega sus ganancias prácticas cuando la implementación y el hardware pueden aprovecharlas.
2020–2025: recurrencia, convoluciones y memoria estructurada vuelven al centro
El artículo Transformers are RNNs, de 2020, mostró una formulación de atención lineal con interpretación recurrente. Reorganizar la operación permite actualizar un estado en lugar de guardar explícitamente todas las relaciones. Esto implica una atención diferente de la softmax convencional, no una simple aceleración exacta de la misma fórmula. Linear Attention [22].
S4 y Mamba: espacio de estados con selección por contenido
S4, en 2021, exploró modelos estructurados de espacio de estados para secuencias largas. La idea es representar la dinámica de un estado y su transformación en salida con una parametrización que permita un procesamiento eficiente. S4 [23].
Mamba, presentado en diciembre de 2023, añadió selectividad dependiente de la entrada: los mecanismos que controlan cómo entra, permanece y se lee la información pueden cambiar según el contenido. Esa selectividad exige un algoritmo de procesamiento adecuado; no consiste solo en reutilizar la convolución de un sistema lineal fijo. Mamba [24].
Mamba-2, en 2024, desarrolló la dualidad entre modelos de espacio de estados y formas de atención estructurada mediante el framework SSD. La relación matemática permite nuevos algoritmos; no demuestra que cualquier SSM y cualquier Transformer sean sustitutos equivalentes para toda tarea. Mamba-2 y SSD [25].
En la ejecución recurrente con dimensiones fijas, el estado de estas capas no crece con cada token del historial. El precio es representar el pasado en una capacidad finita, en lugar de mantener un registro KV separado para cada posición. Recuperar exactamente un detalle antiguo sigue siendo una cuestión que hay que evaluar.
RetNet, RWKV y DeltaNet: otras formas de actualizar la memoria
RetNet, en 2023, presentó un mecanismo de retención con formas paralela, recurrente y por bloques. RWKV exploró una organización que se puede entrenar en paralelo, pero que realiza inferencia recurrente. Son líneas relacionadas con la búsqueda de eficiencia en secuencias, no simplemente nombres nuevos para Mamba. RetNet [26], RWKV [27].
La atención lineal con puertas, como GLA, permite modular la actualización de un estado matricial. DeltaNet, en 2024, explora una regla de actualización correctiva de la memoria; Gated DeltaNet, presentado en ICLR 2025, combina esa escritura correctiva con olvido adaptativo. Esto ofrece formas diferentes de controlar qué se retiene y qué se sustituye. GLA [28], DeltaNet [29], Gated DeltaNet [30].
Las formas recurrentes de inferencia y los algoritmos paralelos de entrenamiento son dos caras de esta ingeniería. Un estado de tamaño fijo respecto al historial no significa coste cero, ni entrenamiento entero con memoria constante: las dimensiones, activaciones, bloques y estrategia de implementación siguen importando.
Las convoluciones también siguieron evolucionando
Hyena, de 2023, combina convoluciones largas parametrizadas y puertas para mezclar información sin la atención completa convencional. Es otra línea de operadores para secuencias. Hyena [31].
El informe LFM2, de 2025, muestra una combinación distinta: muchas capas de convolución corta con puertas y algunas capas GQA, orientada a restricciones de ejecución en dispositivos. La memoria de la convolución local no elimina la caché de las capas de atención que siguen en el modelo. Informe LFM2 [32].
2024: el MoE de granularidad fina cambia la unidad de especialización
Ahora podemos volver al MoE con una pregunta más precisa: ¿cuántos expertos, de qué tamaño, se combinan para cada token?
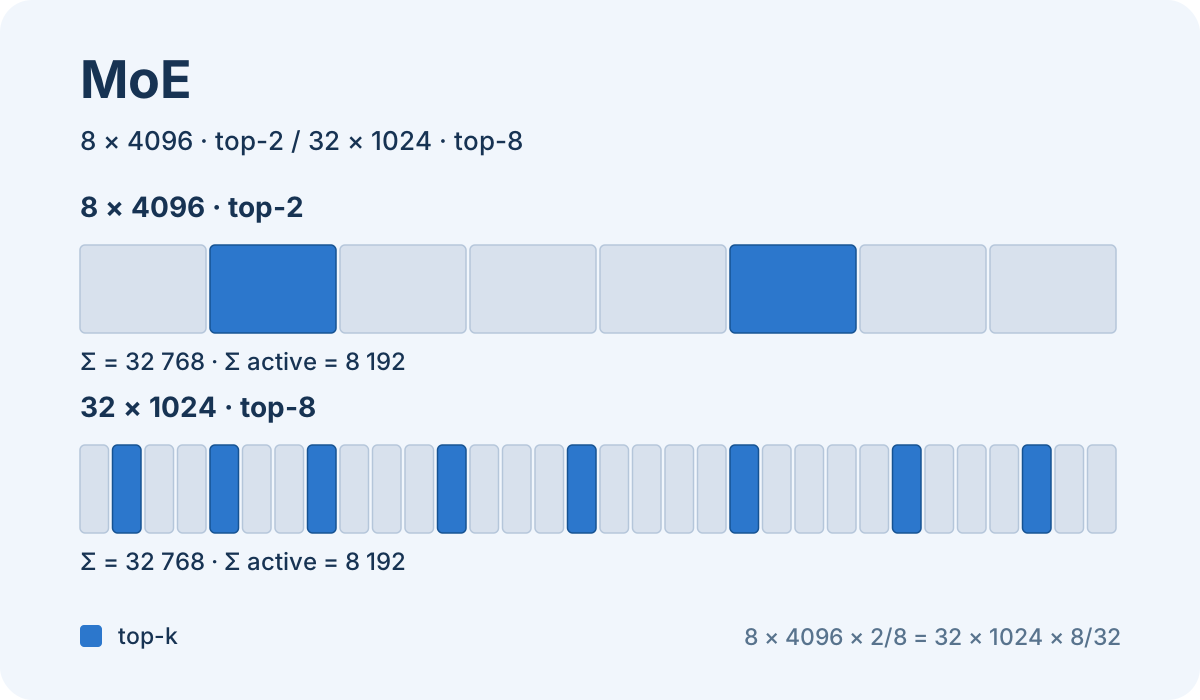
En DeepSeekMoE, de enero de 2024, una FFN experta de anchura intermedia h puede sustituirse, en el diseño de la arquitectura, por m expertos menores de anchura h/m. Las dimensiones de entrada y salida se mantienen. El total pasa de N a mN expertos y la cantidad seleccionada pasa de K a mK. La comparación conserva el presupuesto nominal de los expertos. DeepSeekMoE, sección 3.1 [33].
Son redes menores con pesos y selección aprendidos, no simples trozos de una red ya entrenada que conservarían automáticamente la misma función. Los trabajos sobre leyes de escala empezaron a estudiar la granularidad junto con el tamaño y la cantidad de datos: el mejor punto depende del presupuesto y del régimen estudiado. Scaling Laws for Fine-Grained MoE [34].
Un ejemplo numérico, sin presentar el cálculo como benchmark
Considera esta comparación ilustrativa entre dos diseños de capa:
Expertos disponibles — Expertos mayores: 8; Granularidad cuatro veces más fina: 32
Expertos seleccionados por token — Expertos mayores: 2; Granularidad cuatro veces más fina: 8
Anchura intermedia de cada experto — Expertos mayores: 4.096; Granularidad cuatro veces más fina: 1.024
Suma de anchuras disponibles — Expertos mayores: 32.768; Granularidad cuatro veces más fina: 32.768
Suma de anchuras seleccionadas — Expertos mayores: 8.192; Granularidad cuatro veces más fina: 8.192
Conjuntos posibles de expertos seleccionados — Expertos mayores: 28; Granularidad cuatro veces más fina: 10.518.300
Los números se eligieron para explicar la transformación; no describen un modelo medido aquí. El último cálculo es combinatorio: elegir 2 de 8 u 8 de 32, sin contar el orden ni los pesos de la combinación.
Para FFN de la misma familia y con la misma dimensión de entrada, estas sumas ayudan a comparar parámetros y multiplicaciones de los expertos, ignorando sesgos y otras partes. No contabilizan el router, el despacho, la comunicación ni la eficiencia de los kernels.
El segundo diseño puede elegir combinaciones más variadas de transformaciones menores. Esto crea flexibilidad potencial; no convierte millones de combinaciones en millones de capacidades demostradas. El entrenamiento debe aprender a aprovecharlas.
Expertos compartidos y equilibrio
Los expertos compartidos se ejecutan para todos los tokens en las capas que los incluyen. Los expertos enrutados se seleccionan dinámicamente. La propuesta busca reducir la repetición de funciones comunes entre expertos y dejar más espacio para la diferenciación. DeepSeek-V2 combina esta organización de FFN con MLA en la atención. DeepSeek-V2 [35].
En la comparación de presupuesto de DeepSeekMoE, reservar expertos compartidos exige descontarlos de la cantidad enrutada activa. De lo contrario, se añade cómputo en lugar de reorganizarlo. DeepSeekMoE, sección 3.2 [33].
El router también debe manejar la carga. Si muchos tokens llegan al mismo dispositivo, ese destino puede convertirse en el cuello de botella. El desequilibrio de trabajo y el colapso de la especialización son problemas relacionados, pero no idénticos.
DeepSeek-V3, a finales de 2024, utiliza ajustes de sesgo para equilibrar el enrutamiento sin depender de una pérdida auxiliar principal de equilibrio; el informe aún incluye una pequeña pérdida auxiliar por secuencia. También limita los nodos a los que se envía un token. “Auxiliary-loss-free” no significa que no exista ninguna pérdida auxiliar en el entrenamiento. DeepSeek-V3 [36].
Hay otras opciones. En Expert Choice, de 2022, cada experto selecciona un conjunto de tokens, lo que permite que un token reciba cantidades diferentes de expertos. Esto difiere del top-k por token y de un árbol jerárquico. Restringir destinos por dispositivo o nodo tampoco demuestra la existencia de un árbol de especializaciones semánticas. Expert Choice Routing [37].
Los parámetros activos no son la memoria total
Activar menos expertos puede reducir el cálculo de las FFN por token. Los pesos de los demás expertos siguen existiendo: deben residir en algún lugar y estar disponibles cuando se seleccionen.
Distribuirlos entre dispositivos introduce despacho y comunicación, a menudo con intercambios entre muchos destinos. Mantenerlos fuera de la memoria rápida puede introducir transferencias y latencia. La ganancia final depende del lote, la interconexión, la distribución de tokens y el runtime. La ingeniería de comunicación ocupa una parte importante de los trabajos de escala. GShard [13].
Un MoE con 37B de parámetros activos no puede tratarse automáticamente como un modelo denso de 37B en requisitos de memoria o velocidad.
2024–2026: las líneas coexisten en el mismo modelo
Jamba, presentado en 2024, combina capas Mamba y Transformer, con MoE en parte de las transformaciones. Es una demostración clara de que “recurrente”, “atención” y “expertos” no son categorías mutuamente excluyentes. Las capas de atención siguen teniendo su caché; las recurrentes tienen su propio estado. Jamba [38].
Comprimir KV y seleccionar contexto: MLA, NSA y DSA
La MLA de DeepSeek-V2, en 2024, comprime la representación KV por posición en un espacio latente, con un tratamiento propio de la información posicional. Reduce la cantidad guardada por token; eso no hace automáticamente constante el número de posiciones conservadas. DeepSeek-V2 [35].
En 2025, Native Sparse Attention investigó la combinación de compresión, selección y acceso local con un diseño alineado con el hardware. DeepSeek Sparse Attention, descrita en el informe V3.2, utiliza un indexador para seleccionar las posiciones que llegan a la atención principal. Seleccionar menos posiciones no elimina el coste de seleccionarlas: hay que examinar el sistema entero antes de prometer complejidad lineal o velocidad. NSA [39], DeepSeek-V3.2 [40].
Tres ejemplos actuales, con configuraciones públicas
Qwen3.5-35B-A3B-Base, 2026. La ficha del modelo describe 40 capas organizadas en grupos de tres capas Gated DeltaNet para una Gated Attention, con MoE en ambos tipos. Informa de 35B de parámetros totales, aproximadamente 3B activos y, en las capas MoE, ocho expertos enrutados activos y uno compartido. Es una combinación concreta de memoria recurrente, atención y selección de FFN. Model card [41], configuración oficial [42].
MiMo-V2-Flash, informe de enero de 2026. Combina MoE con 309B de parámetros totales y 15B activos, con atención de ventana deslizante y atención global. El informe describe una proporción de cinco capas locales por una global. Esto reduce el alcance local por capa sin convertir todas las capas en atención local. Las proporciones de una versión no deben copiarse automáticamente a toda la familia MiMo. Informe [43].
DeepSeek-V4, lanzado en abril de 2026. La ficha del proveedor mantiene DeepSeekMoE y describe atención híbrida con CSA y HCA. CSA comprime la secuencia y aplica selección dispersa; HCA usa una compresión más fuerte con atención densa sobre la representación comprimida. La ficha informa de 1,6 billones de parámetros totales y 49B activos para la variante Pro. Ficha técnica oficial [44].
V4 también introduce mHC, que reorganiza la comunicación entre flujos residuales con restricciones sobre su mezcla. Esto actúa en otro eje de la arquitectura: la circulación de representaciones entre bloques, además de la selección de expertos y el acceso al contexto. La documentación de la implementación explicita estos componentes. DeepSeek-V4 en Transformers [45].
Las rutas de atención de estos modelos siguen almacenando información KV. En el Qwen citado, el estado de las capas recurrentes y el KV de las capas de atención tienen comportamientos diferentes. En MiMo, la ventana limita los bloques locales, mientras los globales tienen otro alcance. En V4, la compresión y la selección reducen el volumen consultado; no hacen que todo almacenamiento sea independiente del historial.
Estos ejemplos son configuraciones documentadas, no una clasificación de calidad. Los parámetros activos, el número de expertos y el contexto anunciado no son benchmarks intercambiables.
2024–2026: también cambian la profundidad, la unidad de procesamiento y la generación
El mapa sigue incompleto si solo miramos las FFN y la atención. Otras líneas cambian dónde se gasta el cómputo y cómo se produce la salida.
Recurrencia en profundidad: reutilizar transformaciones en varios pasos sobre una representación tiene antecedentes como Universal Transformers, de 2018. En 2025, un estudio sobre profundidad recurrente exploró aumentar el cálculo en el espacio latente repitiendo un bloque, en vez de depender únicamente de producir más tokens. Reutilizar pesos reduce la necesidad de parámetros distintos para cada paso, pero repetir el bloque sigue costando cómputo. Es otro eje de investigación, diferente de transportar estado entre tokens. Universal Transformers [46], profundidad recurrente, 2025 [47].
Mixture-of-Depths, 2024: selecciona qué tokens participan en las operaciones de determinadas capas, bajo un presupuesto. La selección cambia la distribución del cómputo a través de la profundidad; no equivale simplemente a escoger expertos dentro de una FFN. MoD [48].
Byte Latent Transformer, 2024: agrupa bytes en parches de longitud variable y ejecuta una parte importante del procesamiento sobre esas representaciones, con componentes locales para entrada y salida. Aquí también cambia la unidad sobre la que se organiza el cómputo más caro. BLT [49].
Multi-Token Prediction, 2024: añade objetivos y módulos para predecir más de un token futuro. Hay que separar el entrenamiento del uso de esos módulos en la generación. El trabajo de Gloeckle y sus colegas presenta esta investigación; en DeepSeek-V3, los módulos pueden descartarse en la inferencia o utilizarse para apoyar la decodificación especulativa. Por tanto, decir que MTP “no cambia nada en la inferencia” es demasiado absoluto. MTP [50], uso en V3 [36].
Difusión para lenguaje, como LLaDA, 2025: explora reconstruir tokens enmascarados en lugar de continuar solo de izquierda a derecha. Puede utilizar un backbone Transformer, pero cambia el objetivo y el proceso de generación. Refinar varias posiciones por etapas tiene costes distintos de generar un token por paso; no se debe suponer una latencia menor solo porque exista paralelismo. LLaDA [51].
Memoria aprendida durante el uso, como Titans, en el cambio de 2024 a 2025: investiga módulos de memoria a largo plazo actualizados en tiempo de prueba. Este tipo de memoria no es una base externa de documentos ni solo la caché KV. Es una línea de investigación con reglas propias de actualización, coste y evaluación. Titans [52].
En 2026, Mamba-3 también continúa desarrollando la línea de espacio de estados. La existencia de un nuevo paper amplía el mapa, pero no demuestra una adopción generalizada ni superioridad sobre modelos de escalas y tareas diferentes. Mamba-3 [53].
La línea temporal, sin convertir ramificaciones en sustituciones
1990–1997: recurrencia y LSTM — Qué se vuelve posible investigar u organizar mejor: Transportar y controlar el estado al procesar secuencias.
1991–1994: mezclas de expertos — Qué se vuelve posible investigar u organizar mejor: Dividir y combinar funciones aprendidas, incluso jerárquicamente.
2014: seq2seq y atención — Qué se vuelve posible investigar u organizar mejor: Transformar secuencias y consultar posiciones de entrada durante la generación.
2017: sparse-gated MoE y Transformer — Qué se vuelve posible investigar u organizar mejor: Escalar la selección de subredes y reorganizar la comunicación entre posiciones.
2018–2019: GPT, BERT y T5 — Qué se vuelve posible investigar u organizar mejor: Explorar decodificadores, codificadores y combinaciones encoder-decoder.
2019–2023: MQA, atención dispersa, FlashAttention y GQA — Qué se vuelve posible investigar u organizar mejor: Reducir KV, elegir conexiones y mejorar la ejecución mediante mecanismos distintos.
2020–2024: atención lineal, S4, Mamba y SSD — Qué se vuelve posible investigar u organizar mejor: Actualizar memoria estructurada y acercar perspectivas recurrentes y paralelas.
2024: fine-grained MoE, MLA, Jamba y DeltaNet — Qué se vuelve posible investigar u organizar mejor: Refinar expertos, comprimir KV, combinar operadores y controlar la escritura de memoria.
2024–2025: MoD, BLT, MTP y difusión — Qué se vuelve posible investigar u organizar mejor: Cambiar la profundidad ejecutada, la unidad de procesamiento y la generación.
2025–2026: NSA, DSA, LFM2 e híbridos públicos recientes — Qué se vuelve posible investigar u organizar mejor: Combinar estas decisiones en configuraciones específicas de modelos.
Los años indican los hitos discutidos y sus fuentes, no una afirmación de que toda idea comenzara allí. Existen trabajos anteriores, versiones posteriores y otras líneas. La cronología explica cómo se conectan los mecanismos; no establece un ganador.
Cómo leer la arquitectura de un modelo sin perderse en los nombres
En lugar de preguntar solo si el modelo es denso o MoE, busca respuestas para cinco preguntas:
1. ¿Cómo intercambian información las posiciones? ¿Atención completa, ventanas, selección dispersa, convolución, recurrencia o combinación? 2. ¿Qué transformaciones se ejecutan? ¿FFN densas, expertos enrutados, compartidos o profundidad variable? 3. ¿Qué crece con el historial? Hay que separar KV por posición, representaciones comprimidas, estado recurrente y buffers locales. 4. ¿Cómo aprende y genera el modelo? El siguiente token, MTP, difusión y decodificación especulativa no son la misma decisión. 5. ¿Qué implementación sustentó los resultados? La precisión numérica, el lote, el contexto, los kernels y el hardware definen el coste observado.
Para comparar eficiencia, mide prefill, latencia por token, throughput, memoria y calidad en las tareas relevantes, con condiciones equivalentes. Un resultado de laboratorio o un número de parámetros activos no demuestra por sí solo una mejora general.
El avance más interesante de este recorrido es la libertad de componer: usar expertos menores donde ayuda la combinación, memoria recurrente donde basta el estado y un acceso más directo al contexto donde sea necesario. Cada elección debe justificar qué conserva, qué comprime y qué cuesta cuando el modelo realmente empieza a trabajar.
Fuentes y lecturas
- [1] Elman, 1990
- [2] LSTM
- [3] MoE, 1991
- [4] mezclas jerárquicas, 1994
- [5] Seq2seq
- [6] Atención para traducción neuronal
- [7] Attention Is All You Need
- [8] BERT, 2018
- [9] GPT, 2018
- [10] T5, 2019
- [11] LLaMA
- [12] Sparsely-Gated MoE
- [13] GShard
- [14] Switch Transformers
- [15] Anuncio
- [16] paper de Mixtral
- [17] MQA y coste de decodificación
- [18] GQA
- [19] Longformer
- [20] BigBird
- [21] FlashAttention
- [22] Linear Attention
- [23] S4
- [24] Mamba
- [25] Mamba-2 y SSD
- [26] RetNet
- [27] RWKV
- [28] GLA
- [29] DeltaNet
- [30] Gated DeltaNet
- [31] Hyena
- [32] Informe LFM2
- [33] DeepSeekMoE, sección 3.1
- [34] Scaling Laws for Fine-Grained MoE
- [35] DeepSeek-V2
- [36] DeepSeek-V3
- [37] Expert Choice Routing
- [38] Jamba
- [39] NSA
- [40] DeepSeek-V3.2
- [41] Model card
- [42] configuración oficial
- [43] Informe
- [44] Ficha técnica oficial
- [45] DeepSeek-V4 en Transformers
- [46] Universal Transformers
- [47] profundidad recurrente, 2025
- [48] MoD
- [49] BLT
- [50] MTP
- [51] LLaDA
- [52] Titans
- [53] Mamba-3