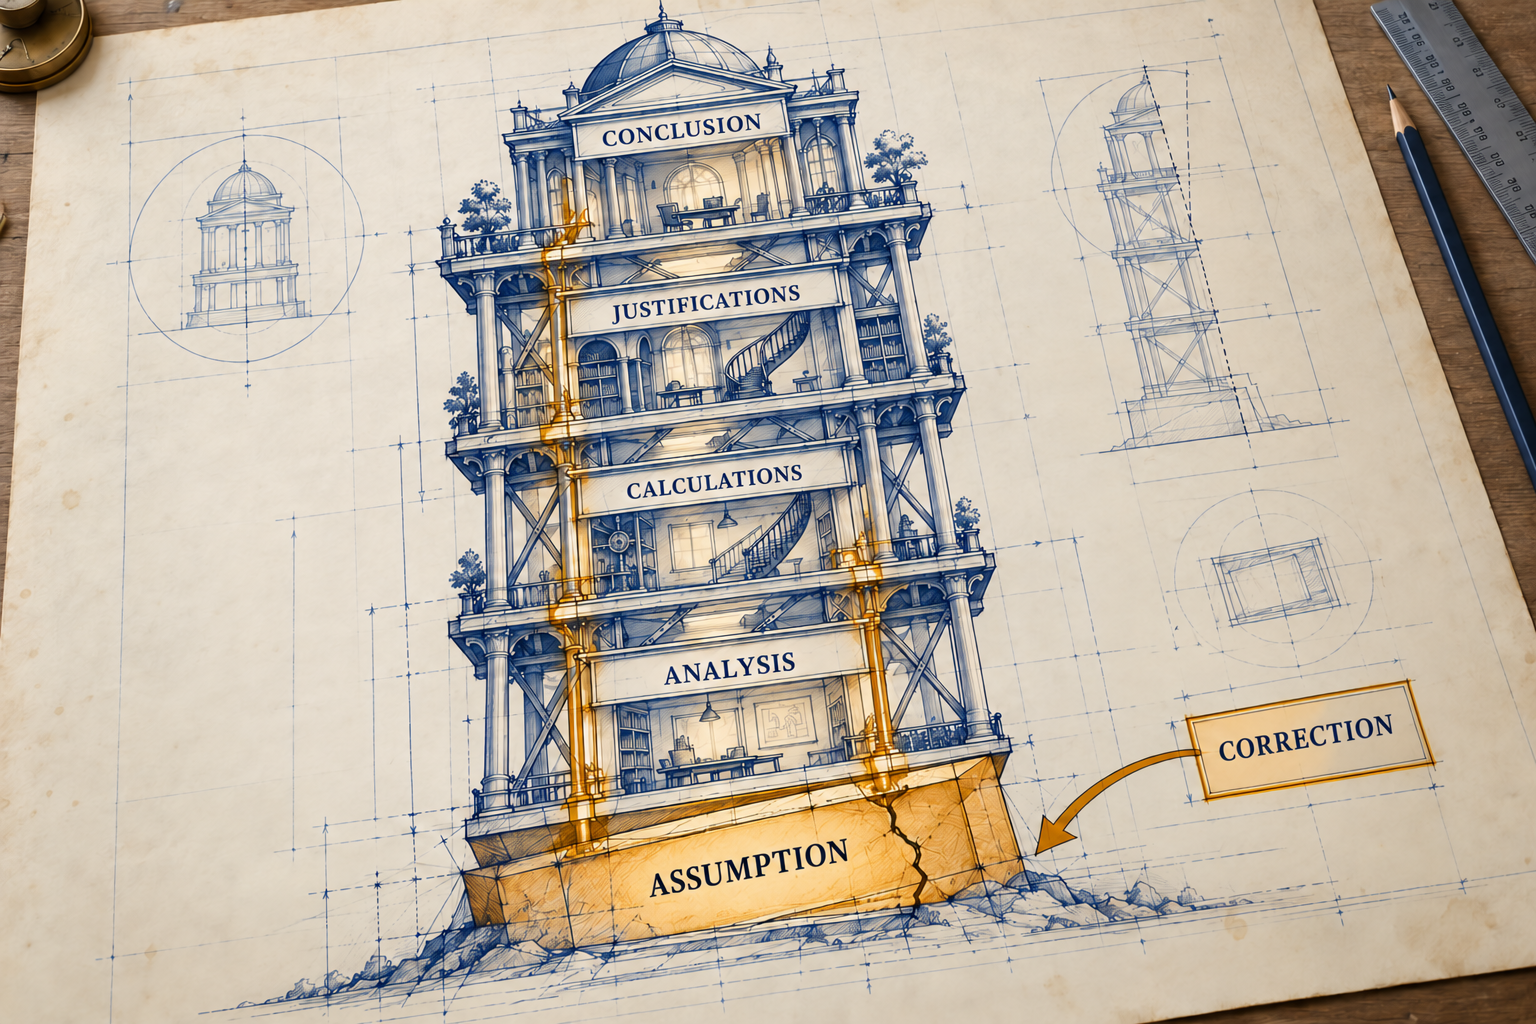
Uma premissa errada pode atravessar uma resposta inteira. Dar mais espaço para o raciocínio também precisa dar espaço para rever o ponto de partida.
Cena hipotética.
A pesquisadora tem baixa visão e trabalha por voz, com leitor de tela. Ela entrega a uma IA uma tabela de um estudo pequeno. Os mesmos participantes realizaram uma tarefa antes e depois de uma mudança de interface.
Ela pergunta: “Essa diferença é significativa?”
Na explicação apresentada pelo modelo aparece uma decisão: “Vou tratar os dois grupos como amostras independentes.”
Só que não são dois grupos independentes. São as mesmas pessoas medidas duas vezes.
O modelo segue. Escolhe uma análise baseada naquela suposição, apresenta contas e conclui que a diferença não é significativa. Sugere até reescrever a discussão do artigo para “não exagerar o efeito”.
A resposta chega organizada. A premissa que sustenta a organização está errada.
Não temos dados reais nessa cena para calcular significância ou escolher um teste completo. O erro ilustrado é anterior: o sistema desconsiderou o vínculo entre as medidas. A escolha da análise também exigiria examinar o desenho, a variável e suas condições.
A pesquisadora corrige: “São medidas repetidas, com os mesmos participantes.”
Agora ela precisa conferir outra coisa: a correção mudou a análise ou apenas acrescentou uma desculpa antes da mesma conclusão?
O que estou chamando de autoenvenenamento
Uso autoenvenenamento como uma metáfora para a propagação de uma suposição produzida pelo próprio modelo. Ele introduz uma premissa inadequada e constrói respostas que continuam apoiadas nela.
O termo aproxima fenômenos estudados como acúmulo de erros e hallucination snowballing. Não estou propondo que sejam todos o mesmo mecanismo, nem descrevendo uma intenção do modelo de enganar ou uma experiência humana de convicção.
Nesta cena, o problema aparece durante uma resposta. Na crônica “Eu corrigi a conversa. A conversa me corrigiu de volta.” [1], ele aparece na continuidade da colaboração. São escalas diferentes para uma pergunta comum: como uma suposição da ferramenta passa a orientar o trabalho depois de ter sido corrigida?
Pensar mais pode ajudar. A premissa ainda precisa estar certa.
O trabalho de Wei e colegas, apresentado em 2022, mostrou ganhos ao oferecer exemplos de resolução passo a passo em tarefas aritméticas, de senso comum e simbólicas. Isso ajudou a estabelecer a cadeia de pensamento, ou chain-of-thought, como uma forma útil de gerar etapas intermediárias. Estudo original [2].
Os modelos atuais foram além desse procedimento de prompting. O GPT-6.1 Sol, por exemplo, é documentado como modelo de raciocínio com diferentes níveis de esforço. A presença desses controles permite ajustar o processamento; o nível escolhido, sozinho, não mede a correção da resposta. Documentação oficial, consultada em 24/10/2026 [3].
Também precisamos separar três coisas: processamento interno, passos intermediários gerados em tokens e explicação entregue à pessoa.
Na API da OpenAI, os tokens brutos de raciocínio não são expostos; quando disponível e solicitado, o sistema oferece um resumo. Portanto, um painel chamado “pensamento” não deve ser presumido como transcrição completa do cálculo. A política de apresentação depende do produto e do modelo. OpenAI Docs — resumos de raciocínio [4].
Na cena da pesquisadora, a premissa errada está na explicação observável. Ela permite conferir a análise proposta. Não permite, por si só, reconstruir cada operação interna que levou à conclusão.
Como um erro pode virar material para o próximo passo
Na geração autorregressiva de texto, a distribuição do próximo token depende da entrada e do prefixo já gerado. Uma representação simplificada é:
P_\theta(y_t \mid x, y_{<t}).Aqui, x representa a entrada, y_t o próximo token e y_<t os tokens anteriores da geração. É uma descrição do condicionamento sequencial, não um diagrama completo de toda arquitetura atual.
Se um passo intermediário errado permanece no material usado para continuar a geração, ele pode influenciar os passos seguintes. Uma fatoração inventada pode sustentar uma conta; uma relação inexistente pode sustentar uma conclusão. É esse encadeamento que interessa investigar.
Nos Transformers com atenção causal, a atenção ajuda a combinar representações das posições permitidas pela máscara. Essa operação, sozinha, não certifica se uma premissa é verdadeira. Há outras transformações na rede, e os modelos podem aprender a revisar o que produziram. Arquitetura do Transformer [5].
Por isso, o salto de “o texto anterior pode influenciar a continuação” para “o modelo sempre reforça o primeiro erro” seria grande demais. O mecanismo oferece uma possibilidade de propagação; a ocorrência e a intensidade precisam ser medidas.
Sistemas também podem registrar a origem de cada afirmação e distinguir hipótese, dado e correção. Essa distinção precisa ter consequência na execução. Escrever “hipótese” ao lado de uma frase não garante que o restante da análise deixe de tratá-la como fato.
O que a pesquisa observou
Erros que produzem outros erros. Em How Language Model Hallucinations Can Snowball, Zhang e colegas estudaram, em 2023, modelos que justificavam uma resposta inicial incorreta com afirmações falsas que conseguiam reconhecer como erradas quando examinadas separadamente. É uma evidência de compromisso com o erro nas configurações avaliadas. Não estabelece uma taxa para os modelos de 2026. Artigo [6].
Explicações que omitem influências. Turpin e colegas mostraram que pistas enviesadas podiam mudar respostas sem serem mencionadas nas justificativas. Isso torna arriscado tratar uma cadeia convincente como prova completa da causa da resposta. O estudo é de 2023 e avalia esse protocolo específico. Artigo [7].
Ordem das premissas. Chen e colegas, em 2024, observaram variação de desempenho ao reorganizar premissas sem mudar o problema lógico. Nas avaliações, a ordem alinhada à resolução favorecia os modelos. Isso indica sensibilidade à apresentação; não prova que a primeira frase determine qualquer resposta. Artigo [8].
Mais processamento com resultados piores em certas tarefas. Gema e colegas construíram tarefas em que ampliar o raciocínio reduzia o desempenho, incluindo contagem com distrações e deduções com restrições. A versão publicada na TMLR em dezembro de 2025 registra diferenças entre modelos e configurações. É um contraexemplo à garantia de ganho, sem transformar “pensar menos” numa regra geral. Estudo e versão publicada [9].
Essas pesquisas observam aspectos relacionados. Juntá-las não demonstra uma única explicação causal para toda resposta confiante e errada.
A pesquisa também avançou sobre como interpretar o raciocínio
Um trabalho de Zaman e Srivastava, publicado na ACL de 2026, questiona uma leitura forte de certos testes de fidelidade: uma explicação omitir uma pista que influenciou a resposta não basta, isoladamente, para concluir que toda a cadeia é uma racionalização posterior.
Os autores comparam medidas e intervenções causais; mostram que a avaliação depende de como “fidelidade” foi definida. Isso não declara todas as cadeias confiáveis. Pede mais cuidado ao usar uma explicação incompleta como evidência de um mecanismo interno específico. Artigo de 2026 [10].
Esse avanço importa para o argumento do post. Podemos apontar uma premissa falsa, verificar seu efeito na análise e exigir uma revisão. Não precisamos afirmar que enxergamos todo o processo interno para fazer isso.
Autocorreção pode ser aprendida
O estudo de Huang e colegas, publicado na ICLR de 2024, encontrou dificuldades na autocorreção intrínseca: pedir ao modelo que revisasse a própria resposta sem informação externa podia manter ou agravar erros. São resultados dos modelos e tarefas daquele estudo. Artigo [11].
Depois, o SCoRe mostrou que treinamento por reforço em interações de várias rodadas podia melhorar a autocorreção em matemática e código. O método foi apresentado em 2024 e publicado na ICLR de 2025. SCoRe [12].
Há uma diferença entre pedir “revise” a um modelo e treiná-lo para reconhecer e reparar seus próprios erros. Esses trabalhos ajudam a estudar essa diferença. Não autorizam concluir que todo modelo atual seja incapaz de se corrigir, nem que um treinamento elimine qualquer falha.
O mesmo vale para correções vindas de fora. Uma ferramenta, uma pessoa ou um teste pode fornecer evidência útil. Sua qualidade e a maneira como o sistema a incorpora continuam precisando de conferência.
Conferir o caminho exige mais de uma estratégia
A autoconsistência, proposta por Wang e colegas, gera diferentes caminhos de resolução e combina suas respostas. A diversidade pode ajudar a evitar depender de uma única sequência. Várias amostras do mesmo modelo, porém, podem compartilhar a mesma suposição errada; concordância não certifica verdade. Self-consistency [13].
A supervisão por processo, estudada por Lightman e colegas, avalia etapas intermediárias durante o treinamento de verificadores. No conjunto MATH avaliado, ela superou a supervisão apenas do resultado final. Isso sustenta a importância de verificar passos; não equivale a pedir uma justificativa mais longa ao mesmo modelo e considerá-la validada. Let's Verify Step by Step [14].
Para a pesquisadora, uma verificação externa pode começar pelo desenho do estudo: cada medida anterior precisa corresponder à mesma pessoa na medida posterior. Um programa pode conferir esse pareamento, recalcular a análise especificada e mostrar os dados usados. O programa também exige revisão: executar código não garante que escolhemos o modelo estatístico adequado.
Uma correção precisa alcançar suas consequências
Na cena, eu gostaria de ver uma revisão assim:
Parte do trabalho: Hipótese de trabalho; O que precisa mudar depois da correção: Retirar “amostras independentes” e registrar o pareamento informado
Parte do trabalho: Procedimento; O que precisa mudar depois da correção: Rever a análise conforme o desenho e as condições dos dados
Parte do trabalho: Cálculo e conclusão; O que precisa mudar depois da correção: Recalcular o necessário e mostrar quais resultados foram alterados
Esse é um contrato de colaboração proposto, não a descrição de uma função já disponível na Kuaapy.
Um pedido de desculpas não demonstra que a correção percorreu essas dependências. A pessoa precisa conseguir conferir o que foi retirado, o que foi refeito e de onde veio a conclusão nova.
Isso também permite avaliar o sistema sem exigir acesso a todo raciocínio privado: registrar a suposição apresentada, fornecer a correção e verificar as consequências observáveis.
Num experimento, eu compararia diferentes casos e modos de revisão: pedido genérico para conferir, correção explícita da premissa e correção acompanhada de evidência externa. Mediria acertos recuperados, respostas corretas que viraram erradas, fidelidade aos dados e custo de revisão. Repetições e variação entre casos importam. Aqui apresento o desenho; não resultados de um teste já realizado.
O custo de encontrar a premissa errada
Aqui entra meu argumento de acessibilidade, ainda sem uma medida comparativa própria.
Uma pessoa que revisa com leitor de tela pode precisar percorrer bastante conteúdo para localizar uma suposição no meio da explicação. A navegação por títulos, uma lista curta de hipóteses e a possibilidade de voltar diretamente ao passo corrigido podem reduzir esse esforço.
As experiências variam. Baixa visão, uso de voz e neurodivergência não determinam uma única forma de leitura ou memória de trabalho. O problema de projeto aparece quando a ferramenta exige reconstruir toda a análise para descobrir se ouviu uma correção.
Em vez de presumir que transparência é mostrar mil linhas, eu pediria premissas de trabalho curtas, navegáveis e vinculadas às evidências. Esse registro seria uma ajuda para conferir a tarefa; não precisaria fingir ser uma reprodução integral do processamento interno.
A pesquisadora informou que eram as mesmas pessoas. A resposta seguinte precisa trabalhar com essa informação e tornar verificável a mudança.
Fale com a gente
Você já corrigiu uma suposição e recebeu a mesma conclusão com uma explicação nova? Conte, em particular, qual premissa precisava mudar e o que a ferramenta fez depois. Evite nomes, documentos privados e dados sensíveis. A publicação de um relato exige autorização própria.
Dúvidas, correções e sugestões: [email protected].
Para continuar a leitura
• Wei e colegas — Chain-of-Thought Prompting [2].
• OpenAI Docs — GPT-6.1 Sol [3] e resumos de raciocínio [4].
• Zhang e colegas — Hallucination Snowballing [6].
• Turpin e colegas — Unfaithful Explanations [7].
• Chen e colegas — Premise Order Matters [8].
• Gema e colegas — Inverse Scaling in Test-Time Compute [9].
• Zaman e Srivastava — fidelidade e omissão de pistas, ACL2026 [10].
• Huang e colegas — autocorreção intrínseca [11] e Kumar e colegas — SCoRe [12].
• Wang e colegas — Self-Consistency [13].
• Lightman e colegas — Let's Verify Step by Step [14].
Fontes e leituras
- [1] “Eu corrigi a conversa. A conversa me corrigiu de volta.”
- [2] Estudo original
- [3] Documentação oficial, consultada em 24/10/2026
- [4] OpenAI Docs — resumos de raciocínio
- [5] Arquitetura do Transformer
- [6] Artigo
- [7] Artigo
- [8] Artigo
- [9] Estudo e versão publicada
- [10] Artigo de 2026
- [11] Artigo
- [12] SCoRe
- [13] Self-consistency
- [14] Let's Verify Step by Step