Uma janela de contexto gigante abre possibilidades. A promessa fica incompleta quando o tamanho da entrada passa a valer como prova de que cada detalhe será usado corretamente.
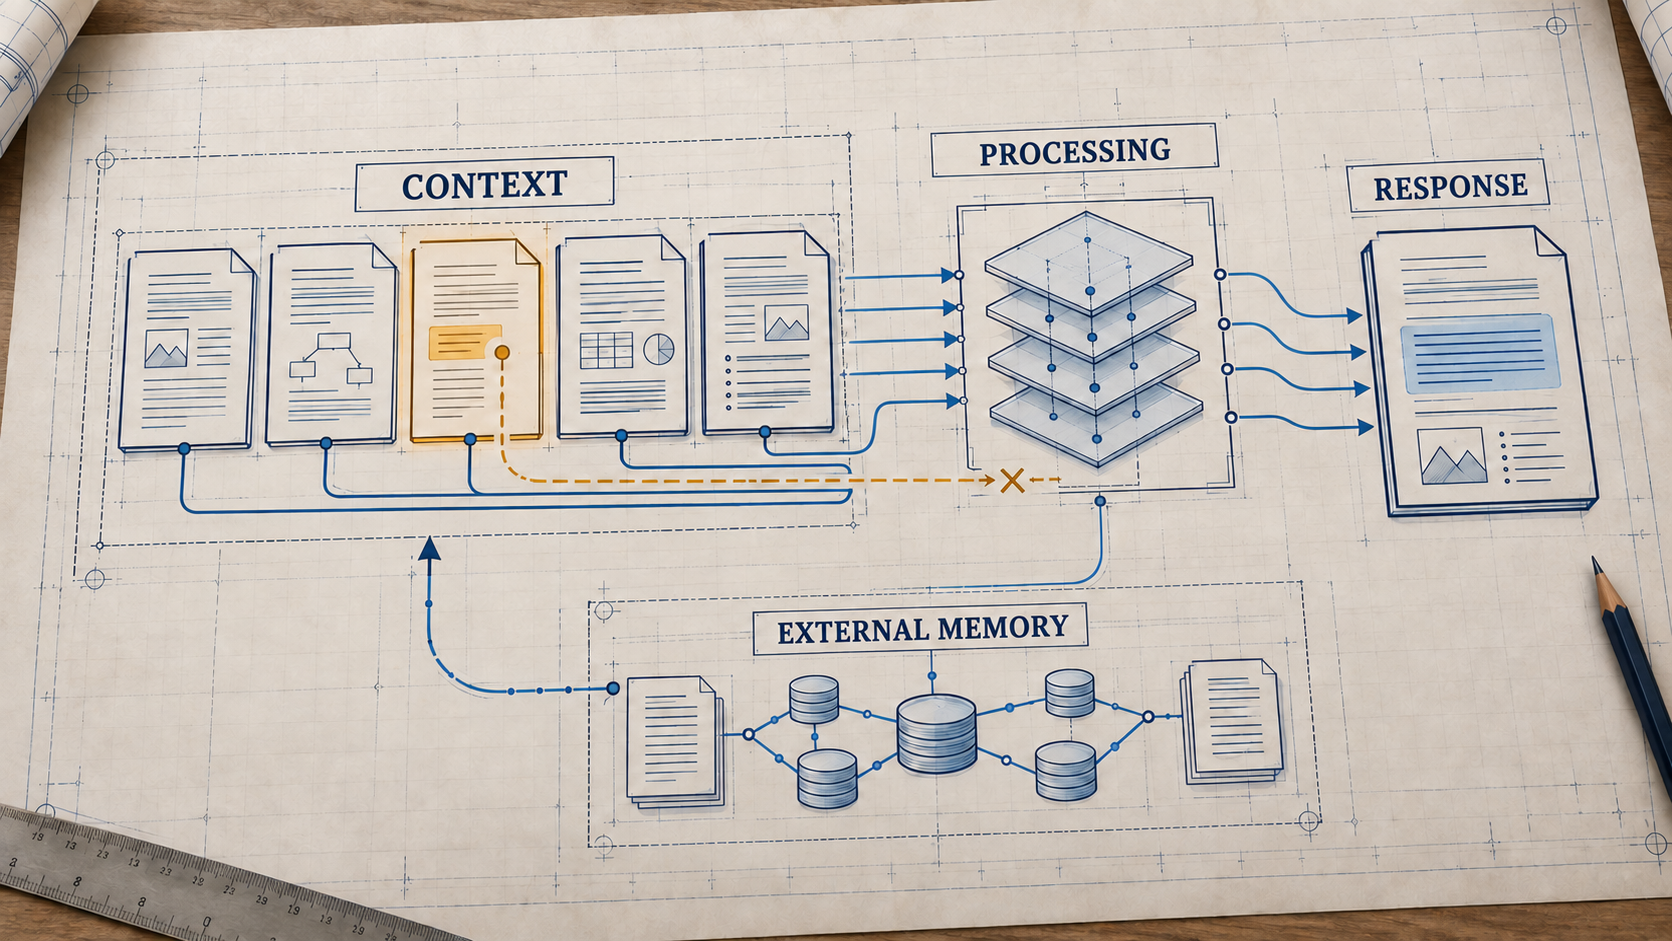
Cena hipotética.
A pesquisadora tem baixa visão. Faz meses que escreve a tese ditando. Fala, revisa ouvindo o leitor de tela, dita de novo. Numa tarde boa, decide usar uma IA anunciada como capaz de “ler um livro inteiro de uma vez”.
Ela entrega os cinco capítulos e as anotações da orientadora. Pede uma conferência específica: a definição de “participação” no capítulo 3 é compatível com a análise do capítulo 5?
A resposta chega rápida, educada e segura. Comenta a introdução e elogia a conclusão. Depois sugere uma definição que contradiz a decisão metodológica registrada no capítulo 3, construída depois de semanas de discussão.
Nenhum aviso apareceu. Nenhuma barra ficou vermelha.
A tese entrou. A decisão importante não chegou à resposta.
Caber é só o começo
Tokens são unidades da representação da entrada: podem corresponder a palavras, partes de palavras, sinais e outros elementos. Não existe conversão fixa de tokens em páginas, especialmente entre idiomas, código e materiais multimodais.
A janela de contexto informa um limite de sequência. O contexto de uma execução é o conteúdo efetivamente disponibilizado para aquela resposta. Instruções, mensagens, documentos e resultados de ferramentas podem ocupar esse espaço; a relação com a saída depende dos limites do sistema.
Há ainda uma diferença que a tela pode esconder. Um documento ou uma conversa continuar visível no aplicativo não prova que ele foi reenviado inteiro ao modelo. O produto pode selecionar, resumir, recuperar ou omitir partes do histórico.
Antes de concluir que o modelo “esqueceu”, precisamos distinguir duas situações: a informação não entrou na chamada, ou entrou e não foi utilizada corretamente. Ambas podem prejudicar a pessoa; a correção técnica é diferente.
Na cena da tese, assumimos que todos os capítulos e as anotações foram enviados na chamada ao modelo. Mesmo assim, aceitar a entrada não garante aplicar a definição certa.
O que as janelas atuais permitem
Na documentação consultada em 24 de outubro de 2026, os limites já são estes:
Modelo e interface documentada: GPT-6.1 Sol, API; Limite de contexto ou entrada: Janela de 1.050.000 tokens; Limite de saída: 128.000 tokens
Modelo e interface documentada: Gemini 4 Argon, API; Limite de contexto ou entrada: Janela unificada de 1.048.576 tokens, compartilhada entre entrada e saída; Limite de saída: 65.536 no modo síncrono padrão; extensão por long decode, dentro da janela compartilhada
Modelo e interface documentada: Gemini 3.8 Flash, API; Limite de contexto ou entrada: Entrada máxima de 1.048.576 tokens; Limite de saída: 65.536 tokens
Fontes: documentação oficial do GPT-6.1 Sol [1], do Gemini 4 Argon [2] e do Gemini 3.8 Flash [3].
Os números precisam vir com o nome do limite. Um teto de entrada não é a mesma coisa que uma janela compartilhada com a resposta. Também não informa quanto do histórico um aplicativo entrega em cada chamada.
Essas capacidades têm valor: permitem trabalhar com documentos, código e relações que não caberiam numa entrada curta. A pergunta seguinte é como o modelo usa o material que recebeu.
O teste precisa alcançar a tarefa
Encontrar uma frase escondida é diferente de relacionar capítulos, contar ocorrências interpretadas ou incorporar uma decisão corrigida.
O RULER, publicado em 2024, já ampliava o teste de “agulha no palheiro” com recuperação, rastreamento de relações e agregação. Seu comprimento efetivo é o maior comprimento avaliado em que o resultado ainda alcança o limiar adotado no conjunto de tarefas. Portanto, depende das tarefas e do limiar escolhido pelos autores. RULER [4].
O NoLiMa, de 2025, reduz a sobreposição literal entre a pergunta e a informação procurada: é preciso recuperar uma associação, em vez de apenas casar palavras. Seus resultados históricos ajudam a entender o problema; não medem o GPT-6.1 ou o Gemini 4. NoLiMa, versão 3 [5].
O Oolong, cuja versão 2 foi revisada em outubro de 2026, acrescenta outra exigência: analisar vários trechos e agregar as análises. Inclui classificação, contagem e relações temporais em dados sintéticos e conversacionais. Aqui, grande parte do contexto pode fazer parte da resposta, em vez de servir apenas de palheiro. Oolong, versão 2 [6].
Nenhum desses testes, sozinho, comprova que um assistente vai conferir corretamente a tese da pesquisadora. Eles mostram por que a avaliação precisa acompanhar a operação que esperamos dele.
O que os dados atuais mostram — e o que falta
Há evidência atual de desempenho forte em contexto longo. No cartão do Gemini 4 Argon, o Google publica estes resultados de GraphWalks, uma tarefa de percorrer relações em grafos por busca em largura, ou BFS:
Subconjunto GraphWalks: Contextos de até 128K tokens; Quantidade de problemas: 650; F1 publicado para Argon: 99,7%
Subconjunto GraphWalks: Contextos entre 256K e 1M tokens; Quantidade de problemas: 200; F1 publicado para Argon: 84,2%
F1 combina precisão (a parcela dos itens recuperados que está correta) e revocação (recall, a parcela dos elementos esperados que foram recuperados); 84,2% de F1 não significa que 84,2% das conversas estejam inteiramente corretas. Os resultados foram calculados pelo Google. Os subconjuntos contêm problemas diferentes: a diferença entre as linhas não isola o efeito de aumentar apenas o comprimento. Resultados [7] e metodologia [8].
Esse resultado merece entrar na conversa: contexto longo pode sustentar trabalho complexo. Também deixa espaço para investigar erros, tarefas diferentes e variação dentro da janela.
Para o GPT-6.1 Sol, encontrei os limites oficiais, mas não uma avaliação equivalente de recuperação em diferentes comprimentos nas fontes OpenAI consultadas. Essa lacuna não demonstra desempenho ruim. As pontuações de gerações anteriores não preenchem essa lacuna, e o tamanho da janela, sozinho, não estabelece sua confiabilidade.
Modelos novos precisam de novas medidas. O desempenho publicado em uma tarefa ajuda a decidir o que testar na próxima; não encerra a avaliação.
O meio pode ser uma região difícil
O estudo Lost in the Middle, publicado na TACL em 2024, observou que mudar a posição da informação relevante alterava o desempenho. Nas tarefas e modelos avaliados, a informação frequentemente era melhor aproveitada nas extremidades do que no meio. Artigo [9].
O estudo é uma referência histórica sobre posição, não um diagnóstico automático dos modelos de 2026. Ajuda a formular uma hipótese para a cena da tese, mas não estabelece que toda informação no meio será ignorada. Para saber se o efeito persiste num modelo atual, precisamos testar sua versão, a tarefa e a posição das evidências.
Para a pesquisadora, porém, a consequência é concreta: ela precisa descobrir que a análise desrespeitou uma decisão que já estava no material. O custo da conferência volta para quem pediu ajuda.
Atenção não é um orçamento mental único
Nos Transformers, mecanismos de atenção relacionam posições da sequência. Em uma atenção causal densa, uma posição pode atender a si mesma e às anteriores permitidas pela máscara. A rede também tem outras transformações, várias camadas e várias cabeças de atenção. Arquitetura original do Transformer [10].
A softmax transforma escores em pesos que somam 1 em cada distribuição de atenção. Essa soma não representa uma única reserva de concentração dividida pelo modelo inteiro.
O trabalho Scalable-Softmax, de Ken M. Nakanishi, investiga o achatamento das distribuições com o aumento do comprimento e propõe uma mudança na normalização. A condição matemática merece acompanhar a metáfora: se a diferença entre os escores permanecer limitada enquanto o número de posições cresce, preservar um peso dominante fica mais difícil. Estudo [11].
Um exemplo simples torna isso visível. Se uma posição tem escore Δ e todas as outras têm escore zero, seu peso é:
p = \frac{e^{\Delta}}{e^{\Delta} + (n-1)}.Mantendo Δ fixo e aumentando o número de posições n, esse peso diminui. Nesse exemplo, manter o mesmo peso exige que Δ cresça como o logaritmo de n−1. Se os escores mudam com o comprimento, a conclusão exige analisar essa mudança. A soma dos pesos, sozinha, não prova que um modelo comercial perderá determinada informação.
Há também os attention sinks: posições iniciais podem receber peso alto mesmo sem trazer conteúdo semanticamente importante. O StreamingLLM estuda esse fenômeno e o usa para melhorar processamento com uma janela limitada. Isso não significa conservar e recuperar toda a história de uma sequência indefinida. StreamingLLM [12].
São pistas de pesquisa sobre mecanismos diferentes. Elas não formam, por simples soma, uma explicação causal completa para cada erro de contexto longo.
A conversa ocupa memória de máquina também
Em modelos que usam KV cache, o sistema guarda estados de chave e valor para reutilizá-los durante a geração. Esse cache é parte do estado de inferência; não corresponde à memória pessoal persistente do produto.
Uma estimativa para camadas de atenção com cache completo e dimensões iguais é:
\text{bytes de KV} = B \times 2 \times L \times n \times H_{KV} \times d_h \times s.Aqui, B é o número de sequências, 2 representa chaves e valores, L é o número de camadas, n é o comprimento retido, H_KV é o número de cabeças de chave/valor, d_h é a dimensão de cada cabeça e s é o número de bytes por elemento.
Para enxergar a ordem de grandeza sem atribuir a conta a um modelo proprietário, vamos usar duas configurações didáticas de atenção com cache completo: uma sequência, oito cabeças KV por camada, dimensão 128 por cabeça e dois bytes por elemento, como em BF16.
Camadas com cache completo: 32; KV por token: 128 KiB; KV para 128.000 tokens: 16,78 GB; KV para 1.000.000 de tokens: 131,07 GB
Camadas com cache completo: 80; KV por token: 320 KiB; KV para 128.000 tokens: 41,94 GB; KV para 1.000.000 de tokens: 327,68 GB
A tabela é aritmética aplicada à fórmula, não uma medição de hardware nem prova de que algum modelo suporte esses comprimentos. Usa GB decimais; GiB, usados em muitas ferramentas de sistema, dão números diferentes. Também não inclui pesos, ativações, buffers ou custos do servidor.
GQA compartilha cabeças de chave/valor entre consultas e reduz o cache em relação a uma configuração com mais cabeças KV. Quantização pode reduzi-lo mais: KIVI e KVQuant, ambos de 2024, são referências de pesquisa sobre representações de poucos bits. A economia real inclui metadados e efeitos na qualidade; passar de 16 para 2 bits não divide toda a aplicação por oito. KIVI [13], KVQuant [14].
Essa fórmula não descreve sozinha todas as arquiteturas atuais. O relatório Qwen3.8-Next, de agosto de 2026, descreve uma combinação de Gated DeltaNet e atenção, com uma camada de atenção global a cada quatro; numa etapa posterior, essas camadas passam a usar Qwen Sparse Attention. Componentes recorrentes e atenção esparsa exigem contas próprias. Relatório técnico [15].
O gerenciador de cache do vLLM também distingue camadas de atenção completa, que retêm todas as posições, e de janela deslizante, que retêm apenas uma faixa recente. A memória depende das camadas e da política de retenção. Não dá para aplicar a conta de cache completo ao modelo inteiro só porque ele aceita um milhão de tokens. Documentação de cache híbrido [16].
Prefill e geração não têm a mesma conta
No prefill, o sistema processa a entrada e prepara estados para a continuação; esse trabalho pode ser dividido em blocos. Na atenção densa, o número de relações entre posições cresce quadraticamente com o comprimento. Mantidas as demais condições, dobrar a entrada aproxima esse componente do cálculo de quatro vezes o trabalho.
Tomando comprimentos explícitos, passar de 128.000 para 1.000.000 de tokens multiplica o termo quadrático por aproximadamente 61. Isso descreve esse componente idealizado, não um aumento garantido de 61 vezes no tempo total da resposta.
No decode com KV cache, cada novo token pode consultar o estado anterior sem recalcular toda a entrada. Para atenção densa e dimensões fixas, esse componente por token cresce aproximadamente de forma linear com o comprimento já retido. Os demais cálculos da rede continuam existindo.
O FlashAttention melhora o uso da hierarquia de memória e evita materializar a matriz inteira de atenção na memória principal da GPU. A variante densa mantém atenção exata e não elimina a ordem quadrática de suas operações. Artigo [17].
O Qwen3.8-Next citado acima é um exemplo atual de por que essas aproximações não podem ser estendidas a toda arquitetura. O custo observado também depende de kernels, hardware, divisão do trabalho, agrupamento de requisições e política de cache. Comprimento, sozinho, não determina a latência.
Há ainda o prefix caching, que reaproveita estados de um prefixo já processado e pode poupar trabalho de prefill. Ele não aumenta a janela por si só nem comprova que a resposta aplicou corretamente uma decisão. A documentação do vLLM distingue esse ganho do trabalho de gerar novos tokens. Prefix caching [18].
Como eu testaria a decisão do capítulo 3
Um teste próximo da cena precisa pedir uma resposta conferível: qual definição vale, em que trecho ela foi estabelecida e como ela muda a análise do capítulo 5.
Eu compararia uma entrada curta com as evidências necessárias, o documento completo e uma versão com recuperação de trechos. Usaria o mesmo modelo e orçamento de resposta, registrando instruções, configuração e o conteúdo efetivamente entregue em cada chamada.
Depois variaria o tamanho do material e a posição da evidência, sem mudar seu sentido nem a ordem das decisões. Incluiria perguntas com palavras diferentes das usadas no documento e casos em que uma correção posterior substitui uma definição antiga.
A conferência observaria acerto da decisão, fidelidade da referência e contradições introduzidas. Vários casos e repetições permitiriam registrar variação e regressões. Esse é um desenho de avaliação proposto; não estou apresentando resultados de um experimento já realizado.
O custo humano não aparece no tamanho da janela
Aqui entra uma hipótese de acessibilidade que quero investigar, sem apresentá-la como estatística já medida.
Uma pessoa que trabalha por ditado pode desenvolver uma ideia em voz alta, voltar a um assunto e explicar novamente uma decisão. Para quem revisa com leitor de tela, localizar uma contradição espalhada numa conversa longa pode exigir uma nova passagem por bastante material.
Algumas pessoas neurodivergentes também podem preferir retomar fios e reorganizar o pensamento durante a conversa. Essas experiências variam. Não há um único jeito de usar voz, ter baixa visão ou pensar com uma ferramenta.
O problema de projeto aparece quando o sistema exige que a pessoa reconstrua repetidamente uma decisão que já comunicou. Mais texto pode aumentar o custo de recuperar a informação certa; a conferência da falha pode custar mais trabalho ainda.
Uma avaliação de acessibilidade precisa observar esse ciclo: o que foi necessário repetir, quanto trabalho deu conferir e se a ferramenta conseguiu incorporar a correção.
Memória que sobrevive à conversa
Na proposta de memória por áreas que venho desenhando, decisões, fontes e relações ficam organizadas fora da conversa corrente. A cada solicitação, o sistema recupera o que pode ajudar naquele momento.
A aposta é preservar continuidade sem exigir que a pessoa cole toda a história de novo. Isso precisa ser demonstrado em testes; guardar informação não garante recuperá-la bem, e recuperar um trecho não garante aplicá-lo corretamente.
Memória externa e contexto longo podem trabalhar juntos. Um resumo pode perder uma exceção; uma busca pode trazer a versão antiga; um grafo pode conservar uma ligação errada. A arquitetura precisa manter origem, correções e possibilidade de revisão, além de escolher o que entra na chamada.
Para quem usa IA hoje, ajuda manter um registro curto de decisões e das fontes completas, pedir referências aos trechos usados e conferir respostas que dependam de alterações importantes. Analisar por partes pode ser útil, desde que a divisão preserve as relações que a tarefa exige.
Colocar instruções decisivas em posição fácil de recuperar é uma estratégia a testar. Não deve virar uma obrigação de reorganizar um livro inteiro para compensar cada ferramenta.
A pesquisadora precisava conferir uma decisão do capítulo 3. O sistema deveria ajudá-la a encontrá-la, relacioná-la ao capítulo 5 e mostrar de onde tirou a resposta.
O tamanho da janela importa. A continuidade do trabalho precisa aparecer no resultado.
Fale com a gente
Você já precisou repetir uma decisão que estava no documento ou na conversa? Conte, em particular, qual informação se perdeu e o que foi preciso fazer para retomar. Evite nomes, documentos privados e dados sensíveis. A publicação de um relato exige autorização própria.
Dúvidas, correções e sugestões: [email protected].
Para continuar a leitura
• RULER — tarefas e comprimento efetivo [4].
• NoLiMa — estudo publicado [5] e resultados adicionais dos autores [19].
• Lost in the Middle — efeito da posição nas avaliações [9].
• Scalable-Softmax — normalização e generalização de comprimento [11].
• StreamingLLM — attention sinks [12].
• FlashAttention — atenção exata e uso da memória [17].
• KIVI [13] e KVQuant [14] — compressão de KV cache.
• GPT-6.1 Sol — limites documentados [1].
• Gemini 4 Argon — resultados [7] e metodologia GraphWalks [8].
• Oolong v2 — agregação e raciocínio em contexto longo [6].
• Qwen3.8-Next — arquitetura híbrida [15].
• vLLM — cache híbrido [16] e reuso de prefixos [18].
Fontes e leituras
- [1] GPT-6.1 Sol
- [2] Gemini 4 Argon
- [3] Gemini 3.8 Flash
- [4] RULER
- [5] NoLiMa, versão 3
- [6] Oolong, versão 2
- [7] Resultados
- [8] metodologia
- [9] Artigo
- [10] Arquitetura original do Transformer
- [11] Estudo
- [12] StreamingLLM
- [13] KIVI
- [14] KVQuant
- [15] Relatório técnico
- [16] Documentação de cache híbrido
- [17] Artigo
- [18] Prefix caching
- [19] resultados adicionais dos autores