Una ventana de contexto gigante abre posibilidades. La promesa queda incompleta cuando el tamaño de la entrada se toma como prueba de que cada detalle se usará correctamente.
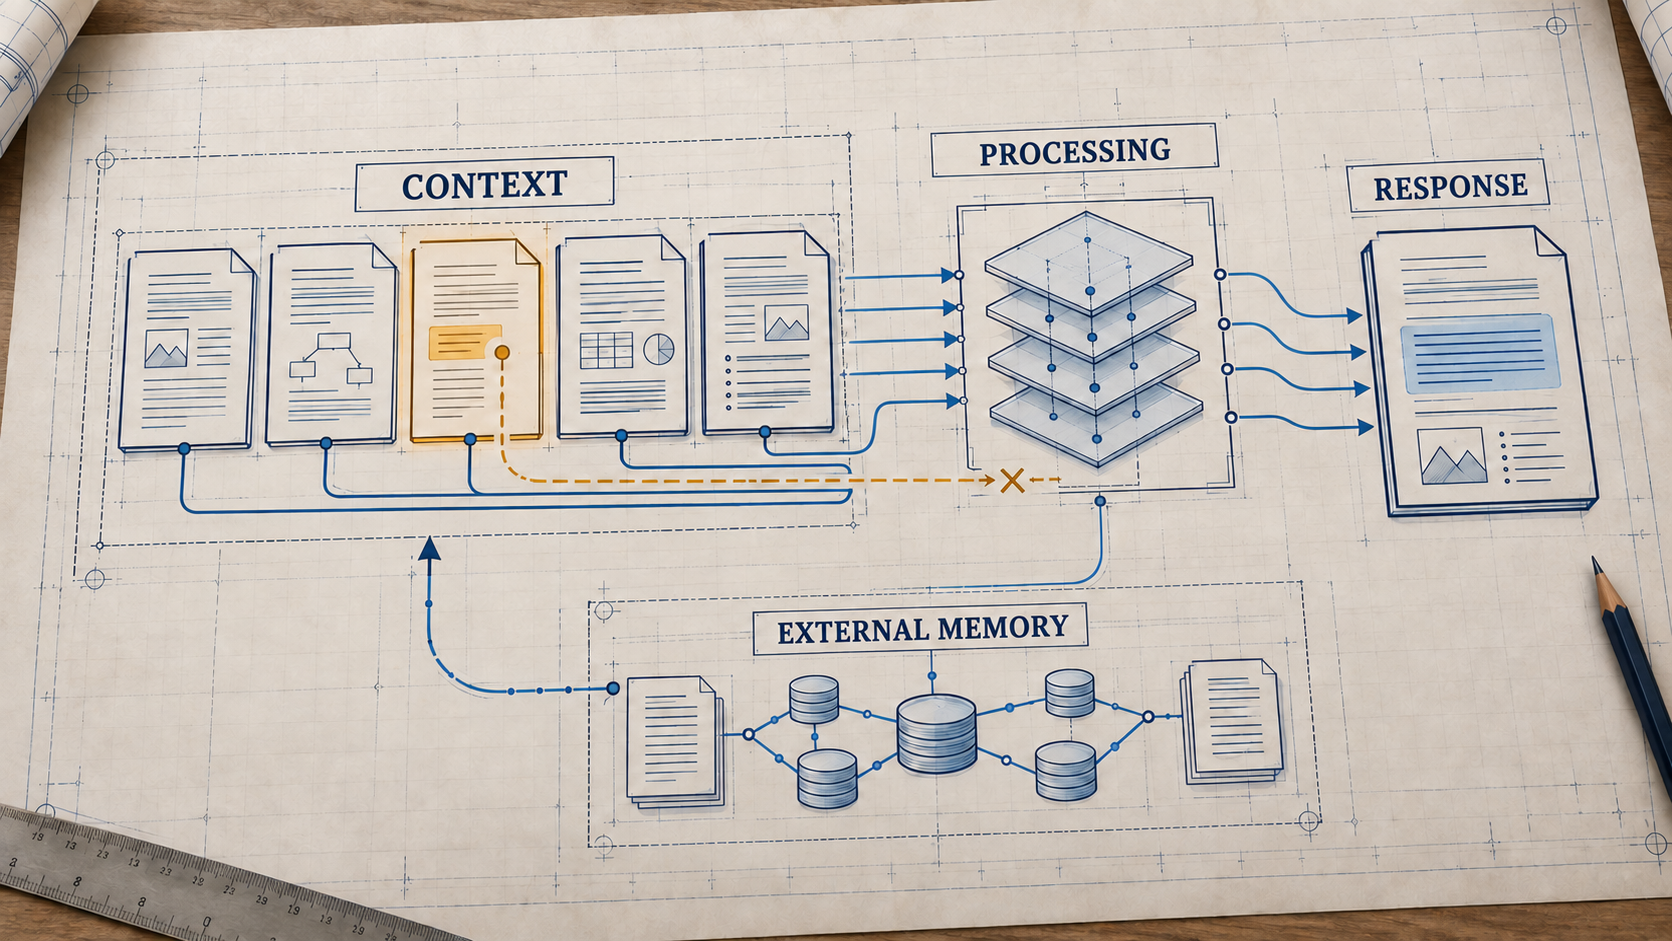
Escena hipotética.
La investigadora tiene baja visión. Lleva meses escribiendo la tesis por dictado. Habla, revisa escuchando el lector de pantalla y vuelve a dictar. Una buena tarde decide usar una IA anunciada como capaz de «leer un libro entero de una vez».
Le entrega los cinco capítulos y las anotaciones de su directora de tesis. Pide una comprobación específica: ¿la definición de «participación» del capítulo 3 es compatible con el análisis del capítulo 5?
La respuesta llega rápida, educada y segura. Comenta la introducción y elogia la conclusión. Después sugiere una definición que contradice la decisión metodológica registrada en el capítulo 3, construida tras semanas de discusión.
No apareció ningún aviso. Ninguna barra se puso roja.
La tesis entró. La decisión importante no llegó a la respuesta.
Caber es solo el principio
Los tokens son unidades de representación de la entrada: pueden corresponder a palabras, partes de palabras, signos y otros elementos. No existe una conversión fija de tokens a páginas, especialmente entre idiomas, código y materiales multimodales.
La ventana de contexto indica un límite de secuencia. El contexto de una ejecución es el contenido que realmente se pone a disposición para esa respuesta. Las instrucciones, los mensajes, los documentos y los resultados de herramientas pueden ocupar ese espacio; su relación con la salida depende de los límites del sistema.
También hay una diferencia que la pantalla puede ocultar. Que un documento o una conversación sigan visibles en la aplicación no prueba que se hayan reenviado completos al modelo. El producto puede seleccionar, resumir, recuperar u omitir partes del historial.
Antes de concluir que el modelo «olvidó», debemos distinguir dos situaciones: la información no entró en la llamada, o entró y no se utilizó correctamente. Ambas pueden perjudicar a la persona; la corrección técnica es diferente.
En la escena de la tesis suponemos que todos los capítulos y las anotaciones se enviaron en la llamada al modelo. Aun así, aceptar la entrada no garantiza aplicar la definición correcta.
Lo que permiten las ventanas actuales
En la documentación consultada el 24 de octubre de 2026, los límites ya son estos:
Modelo e interfaz documentada: GPT-6.1 Sol, API; Límite de contexto o entrada: Ventana de 1.050.000 tokens; Límite de salida: 128.000 tokens
Modelo e interfaz documentada: Gemini 4 Argon, API; Límite de contexto o entrada: Ventana unificada de 1.048.576 tokens, compartida entre entrada y salida; Límite de salida: 65.536 en el modo síncrono predeterminado; extensión mediante long decode, dentro de la ventana compartida
Modelo e interfaz documentada: Gemini 3.8 Flash, API; Límite de contexto o entrada: Entrada máxima de 1.048.576 tokens; Límite de salida: 65.536 tokens
Fuentes: documentación oficial de GPT-6.1 Sol [1], Gemini 4 Argon [2] y Gemini 3.8 Flash [3].
Las cifras deben indicar qué límite representan. Un tope de entrada no es lo mismo que una ventana compartida con la respuesta. Tampoco informa de cuánto historial entrega una aplicación en cada llamada.
Estas capacidades tienen valor: permiten trabajar con documentos, código y relaciones que no cabrían en una entrada corta. La siguiente pregunta es cómo usa el modelo el material recibido.
La prueba debe alcanzar la tarea
Encontrar una frase escondida es diferente de relacionar capítulos, contar apariciones interpretadas o incorporar una decisión corregida.
RULER, publicado en 2024, ya ampliaba la prueba de la «aguja en un pajar» con recuperación, seguimiento de relaciones y agregación. Su longitud efectiva es la mayor longitud evaluada en la que el resultado todavía alcanza el umbral adoptado en el conjunto de tareas. Por tanto, depende de las tareas y del umbral elegido por los autores. RULER [4].
NoLiMa, de 2025, reduce la coincidencia literal entre la pregunta y la información buscada: es necesario recuperar una asociación, en lugar de limitarse a emparejar palabras. Sus resultados históricos ayudan a entender el problema; no miden GPT-6.1 ni Gemini 4. NoLiMa, versión 3 [5].
Oolong, cuya versión 2 se revisó en octubre de 2026, añade otra exigencia: analizar varios fragmentos y agregar los análisis. Incluye clasificación, recuento y relaciones temporales en datos sintéticos y conversacionales. Aquí, gran parte del contexto puede formar parte de la respuesta, en vez de servir solo de pajar. Oolong, versión 2 [6].
Ninguna de estas pruebas, por sí sola, demuestra que un asistente comprobará correctamente la tesis de la investigadora. Muestran por qué la evaluación debe acompañar la operación que esperamos de él.
Lo que muestran los datos actuales — y lo que falta
Hay evidencia actual de buen rendimiento en contexto largo. En la ficha de Gemini 4 Argon, Google publica estos resultados de GraphWalks, una tarea de recorrer relaciones en grafos mediante búsqueda en anchura, o BFS:
Subconjunto GraphWalks: Contextos de hasta 128K tokens; Cantidad de problemas: 650; F1 publicado para Argon: 99,7%
Subconjunto GraphWalks: Contextos entre 256K y 1M tokens; Cantidad de problemas: 200; F1 publicado para Argon: 84,2%
F1 combina precisión (la proporción de elementos recuperados que son correctos) y exhaustividad (recall, la proporción de elementos esperados que se recuperaron); un F1 del 84,2% no significa que el 84,2% de las conversaciones sean completamente correctas. Google calculó los resultados. Los subconjuntos contienen problemas diferentes: la diferencia entre las filas no aísla el efecto de aumentar únicamente la longitud. Resultados [7] y metodología [8].
Este resultado merece entrar en la conversación: el contexto largo puede sostener un trabajo complejo. También deja espacio para investigar errores, tareas diferentes y variación dentro de la ventana.
Para GPT-6.1 Sol, encontré los límites oficiales, pero no una evaluación equivalente de recuperación a distintas longitudes en las fuentes de OpenAI consultadas. Esa ausencia no demuestra mal rendimiento. Las puntuaciones de generaciones anteriores no llenan ese vacío, y el tamaño de la ventana, por sí solo, no establece su fiabilidad.
Los modelos nuevos necesitan medidas nuevas. El rendimiento publicado en una tarea ayuda a decidir qué probar después; no cierra la evaluación.
El medio puede ser una región difícil
El estudio Lost in the Middle, publicado en TACL en 2024, observó que cambiar la posición de la información relevante alteraba el rendimiento. En las tareas y los modelos evaluados, con frecuencia se aprovechaba mejor la información de los extremos que la del medio. Artículo [9].
El estudio es una referencia histórica sobre posición, no un diagnóstico automático de los modelos de 2026. Ayuda a formular una hipótesis para la escena de la tesis, pero no establece que toda información del medio vaya a ignorarse. Para saber si el efecto persiste en un modelo actual, debemos probar su versión, la tarea y la posición de las evidencias.
Para la investigadora, sin embargo, la consecuencia es concreta: necesita descubrir que el análisis incumplió una decisión que ya estaba en el material. El coste de la comprobación vuelve a quien pidió ayuda.
La atención no es un presupuesto mental único
En los Transformers, los mecanismos de atención relacionan posiciones de la secuencia. En una atención causal densa, una posición puede atender a sí misma y a las anteriores permitidas por la máscara. La red también tiene otras transformaciones, varias capas y varias cabezas de atención. Arquitectura original del Transformer [10].
La softmax transforma puntuaciones en pesos que suman 1 en cada distribución de atención. Esa suma no representa una única reserva de concentración repartida entre todo el modelo.
El trabajo Scalable-Softmax, de Ken M. Nakanishi, investiga el aplanamiento de las distribuciones al aumentar la longitud y propone un cambio en la normalización. La condición matemática debe acompañar la metáfora: si la diferencia entre las puntuaciones se mantiene acotada mientras crece el número de posiciones, conservar un peso dominante resulta más difícil. Estudio [11].
Un ejemplo sencillo lo hace visible. Si una posición tiene puntuación Δ y todas las demás tienen puntuación cero, su peso es:
p = \frac{e^{\Delta}}{e^{\Delta} + (n-1)}.Manteniendo Δ fijo y aumentando el número de posiciones n, ese peso disminuye. En este ejemplo, mantener el mismo peso exige que Δ crezca como el logaritmo de n−1. Si las puntuaciones cambian con la longitud, la conclusión exige analizar ese cambio. La suma de los pesos, por sí sola, no prueba que un modelo comercial vaya a perder determinada información.
También están los attention sinks: las posiciones iniciales pueden recibir pesos elevados incluso sin aportar contenido semánticamente importante. StreamingLLM estudia este fenómeno y lo usa para mejorar el procesamiento con una ventana limitada. Eso no significa conservar y recuperar toda la historia de una secuencia indefinida. StreamingLLM [12].
Son pistas de investigación sobre mecanismos distintos. Su simple suma no forma una explicación causal completa para cada error de contexto largo.
La conversación también ocupa memoria de máquina
En los modelos que utilizan KV cache, el sistema guarda estados de clave y valor para reutilizarlos durante la generación. Esta caché forma parte del estado de inferencia; no corresponde a la memoria personal persistente del producto.
Una estimación para capas de atención con caché completa y dimensiones iguales es:
\text{bytes de KV} = B \times 2 \times L \times n \times H_{KV} \times d_h \times s.Aquí, B es el número de secuencias, 2 representa claves y valores, L es el número de capas, n es la longitud retenida, H_KV es el número de cabezas de clave/valor, d_h es la dimensión de cada cabeza y s es el número de bytes por elemento.
Para ver el orden de magnitud sin atribuir la cuenta a un modelo propietario, usaremos dos configuraciones didácticas de atención con caché completa: una secuencia, ocho cabezas KV por capa, dimensión 128 por cabeza y dos bytes por elemento, como en BF16.
Capas con caché completa: 32; KV por token: 128 KiB; KV para 128.000 tokens: 16,78 GB; KV para 1.000.000 de tokens: 131,07 GB
Capas con caché completa: 80; KV por token: 320 KiB; KV para 128.000 tokens: 41,94 GB; KV para 1.000.000 de tokens: 327,68 GB
La tabla es aritmética aplicada a la fórmula, no una medición de hardware ni prueba de que algún modelo admita esas longitudes. Utiliza GB decimales; los GiB, utilizados en muchas herramientas del sistema, dan cifras diferentes. Tampoco incluye pesos, activaciones, búferes ni costes del servidor.
GQA comparte cabezas de clave/valor entre consultas y reduce la caché frente a una configuración con más cabezas KV. La cuantización puede reducirla más: KIVI y KVQuant, ambos de 2024, son referencias de investigación sobre representaciones de pocos bits. El ahorro real incluye metadatos y efectos sobre la calidad; pasar de 16 a 2 bits no divide toda la aplicación por ocho. KIVI [13], KVQuant [14].
Esta fórmula, por sí sola, no describe todas las arquitecturas actuales. El informe Qwen3.8-Next, de agosto de 2026, describe una combinación de Gated DeltaNet y atención, con una capa de atención global cada cuatro; en una etapa posterior, esas capas pasan a utilizar Qwen Sparse Attention. Los componentes recurrentes y la atención dispersa requieren cálculos propios. Informe técnico [15].
El gestor de caché de vLLM también distingue capas de atención completa, que retienen todas las posiciones, y de ventana deslizante, que retienen solo un tramo reciente. La memoria depende de las capas y de la política de retención. No se puede aplicar la cuenta de caché completa a todo el modelo solo porque acepte un millón de tokens. Documentación de caché híbrida [16].
Prefill y generación no tienen el mismo coste
En el prefill, el sistema procesa la entrada y prepara estados para la continuación; este trabajo puede dividirse en bloques. En la atención densa, el número de relaciones entre posiciones crece cuadráticamente con la longitud. Manteniendo las demás condiciones, duplicar la entrada aproxima ese componente a cuatro veces el trabajo.
Con longitudes explícitas, pasar de 128.000 a 1.000.000 de tokens multiplica el término cuadrático por aproximadamente 61. Esto describe ese componente idealizado, no un aumento garantizado de 61 veces en el tiempo total de respuesta.
En la decodificación con KV cache, cada token nuevo puede consultar el estado anterior sin recalcular toda la entrada. Para atención densa y dimensiones fijas, este componente por token crece aproximadamente de forma lineal con la longitud ya retenida. Los demás cálculos de la red siguen existiendo.
FlashAttention mejora el uso de la jerarquía de memoria y evita materializar toda la matriz de atención en la memoria principal de la GPU. La variante densa mantiene la atención exacta y no elimina el orden cuadrático de sus operaciones. Artículo [17].
El Qwen3.8-Next citado antes es un ejemplo actual de por qué estas aproximaciones no pueden extenderse a toda arquitectura. El coste observado también depende de kernels, hardware, reparto del trabajo, agrupación de solicitudes y política de caché. La longitud, por sí sola, no determina la latencia.
También existe el prefix caching, que reutiliza estados de un prefijo ya procesado y puede ahorrar trabajo de prefill. Por sí solo no aumenta la ventana ni demuestra que la respuesta haya aplicado correctamente una decisión. La documentación de vLLM distingue este ahorro del trabajo de generar tokens nuevos. Prefix caching [18].
Cómo probaría la decisión del capítulo 3
Una prueba cercana a la escena debe pedir una respuesta comprobable: qué definición vale, en qué fragmento se estableció y cómo cambia el análisis del capítulo 5.
Compararía una entrada corta con las evidencias necesarias, el documento completo y una versión con recuperación de fragmentos. Utilizaría el mismo modelo y presupuesto de respuesta, registrando instrucciones, configuración y el contenido realmente entregado en cada llamada.
Después variaría el tamaño del material y la posición de la evidencia, sin cambiar su sentido ni el orden de las decisiones. Incluiría preguntas con palabras distintas a las del documento y casos en los que una corrección posterior sustituye una definición antigua.
La comprobación observaría el acierto de la decisión, la fidelidad de la referencia y las contradicciones introducidas. Varios casos y repeticiones permitirían registrar variación y regresiones. Es un diseño de evaluación propuesto; no presento resultados de un experimento ya realizado.
El coste humano no aparece en el tamaño de la ventana
Aquí entra una hipótesis de accesibilidad que quiero investigar, sin presentarla como una estadística ya medida.
Una persona que trabaja por dictado puede desarrollar una idea en voz alta, volver a un tema y explicar de nuevo una decisión. Para quien revisa con lector de pantalla, localizar una contradicción repartida por una conversación larga puede exigir otra pasada por bastante material.
Algunas personas neurodivergentes también pueden preferir retomar hilos y reorganizar el pensamiento durante la conversación. Estas experiencias varían. No hay una única forma de usar la voz, tener baja visión o pensar con una herramienta.
El problema de diseño aparece cuando el sistema exige reconstruir repetidamente una decisión ya comunicada. Más texto puede aumentar el coste de recuperar la información correcta; comprobar el fallo puede costar todavía más trabajo.
Una evaluación de accesibilidad debe observar ese ciclo: qué fue necesario repetir, cuánto trabajo dio comprobarlo y si la herramienta consiguió incorporar la corrección.
Memoria que sobrevive a la conversación
En la propuesta de memoria por áreas que vengo diseñando, las decisiones, las fuentes y las relaciones se organizan fuera de la conversación actual. En cada solicitud, el sistema recupera lo que puede ayudar en ese momento.
La apuesta es preservar la continuidad sin exigir que la persona vuelva a pegar toda la historia. Esto debe demostrarse con pruebas; guardar información no garantiza recuperarla bien, y recuperar un fragmento no garantiza aplicarlo correctamente.
La memoria externa y el contexto largo pueden trabajar juntos. Un resumen puede perder una excepción; una búsqueda puede traer la versión antigua; un grafo puede conservar una relación equivocada. La arquitectura debe mantener el origen, las correcciones y la posibilidad de revisión, además de elegir qué entra en la llamada.
Para quien usa IA hoy, ayuda mantener un registro breve de decisiones y de las fuentes completas, pedir referencias a los fragmentos utilizados y comprobar respuestas que dependan de cambios importantes. Analizar por partes puede ser útil, siempre que la división conserve las relaciones que exige la tarea.
Colocar las instrucciones decisivas en una posición fácil de recuperar es una estrategia que hay que probar. No debe convertirse en la obligación de reorganizar un libro entero para compensar cada herramienta.
La investigadora necesitaba comprobar una decisión del capítulo 3. El sistema debería ayudarla a encontrarla, relacionarla con el capítulo 5 y mostrar de dónde obtuvo la respuesta.
El tamaño de la ventana importa. La continuidad del trabajo debe aparecer en el resultado.
Habla con nosotros
¿Has tenido que repetir una decisión que ya estaba en el documento o en la conversación? Cuéntanos en privado qué información se perdió y qué hizo falta para retomar el trabajo. Evita nombres, documentos privados y datos sensibles. Publicar un relato exige una autorización propia.
Dudas, correcciones y sugerencias: [email protected].
Para seguir leyendo
• RULER — tareas y longitud efectiva [4].
• NoLiMa — estudio publicado [5] y resultados adicionales de los autores [19].
• Lost in the Middle — efecto de la posición en las evaluaciones [9].
• Scalable-Softmax — normalización y generalización de longitud [11].
• StreamingLLM — attention sinks [12].
• FlashAttention — atención exacta y uso de la memoria [17].
• KIVI [13] y KVQuant [14] — compresión de KV cache.
• GPT-6.1 Sol — límites documentados [1].
• Gemini 4 Argon — resultados [7] y metodología GraphWalks [8].
• Oolong v2 — agregación y razonamiento en contexto largo [6].
• Qwen3.8-Next — arquitectura híbrida [15].
• vLLM — caché híbrida [16] y reutilización de prefijos [18].
Fuentes y lecturas
- [1] GPT-6.1 Sol
- [2] Gemini 4 Argon
- [3] Gemini 3.8 Flash
- [4] RULER
- [5] NoLiMa, versión 3
- [6] Oolong, versión 2
- [7] Resultados
- [8] metodología
- [9] Artículo
- [10] Arquitectura original del Transformer
- [11] Estudio
- [12] StreamingLLM
- [13] KIVI
- [14] KVQuant
- [15] Informe técnico
- [16] Documentación de caché híbrida
- [17] Artículo
- [18] Prefix caching
- [19] resultados adicionales de los autores